Strona z pierwszej pozycji Google dostała 1% rekomendacji. Z czwartej - 63%
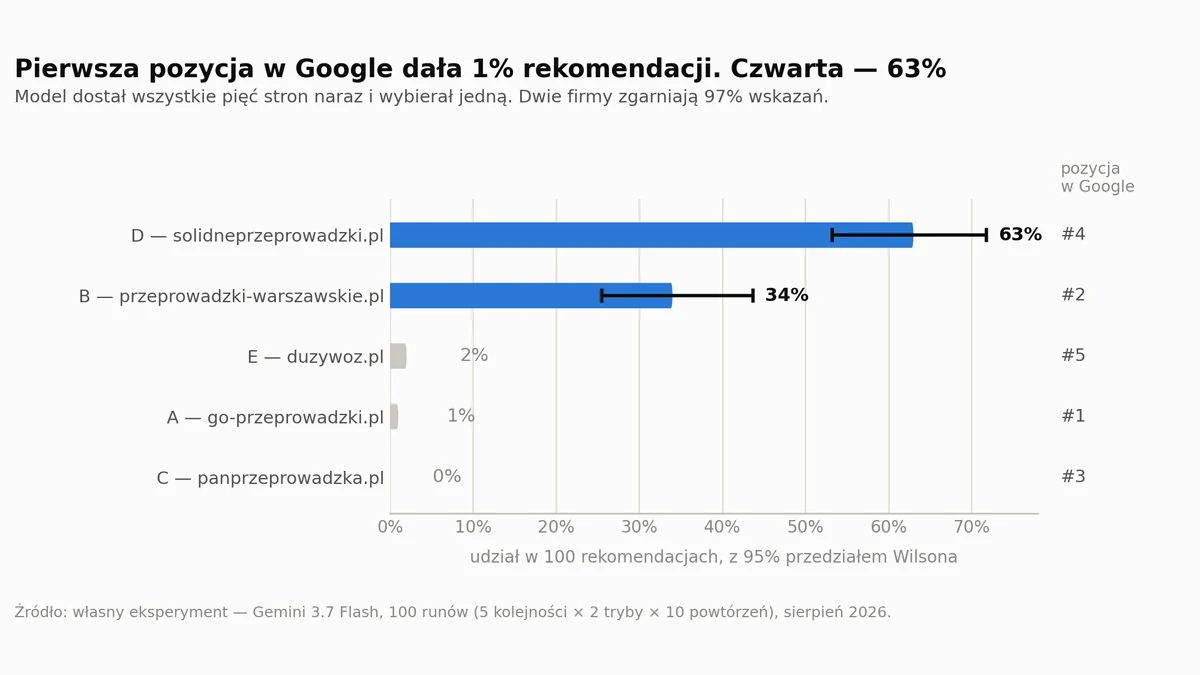
Dałem Gemini pięć realnych firm przeprowadzkowych z pierwszej strony Google i kazałem wybrać jedną. Sto razy. Wynik nie ma prawie nic wspólnego z rankingiem organicznym - ale zanim ktoś ogłosi śmierć SEO, jest w tych danych coś, co powinno ostudzić każdego, kto sprzedaje pomiary „widoczności w AI".
Pytanie, które postawiłem, jest proste: kiedy model dostaje zestaw konkurencyjnych stron i ma polecić jedną, co właściwie decyduje?
To nie jest to samo co „czy AI mnie cytuje". Cytowanie to jedno zdanie w odpowiedzi. Rekomendacja to koniec ścieżki zakupowej - moment, w którym klient dostaje jedną nazwę i idzie dalej. Dla firmy usługowej to jest ta metryka, która ma znaczenie.
Jak to zmierzyłem
Pięć firm rankujących na „przeprowadzki Warszawa", pozycje 1-5. Dla każdej wziąłem URL rankujący, nie stronę główną - bo to on realnie startuje w konkurencji. Typ strony zapisałem jako zmienną; wrócę do tego, bo okazał się ważniejszy, niż zakładałem.
Prompt to naturalne zapytanie klienta: przeprowadzka mieszkania trzypokojowego na trzecie piętro bez windy, w obrębie Warszawy. Do tego pięć adresów i prośba o zalety, wady i jeden wybór. W prompcie wymieniłem sześć kryteriów, na które model ma zwrócić uwagę: przejrzystość cen, opłaty dodatkowe, ubezpieczenie, zasady anulacji, wiarygodność firmy i kompletność informacji na stronie.
Plan eksperymentu: kwadrat łaciński - pięć kolejności URL-i, w których każda firma trafia na każdą pozycję dokładnie tyle samo razy - × dwa tryby × dziesięć powtórzeń = 100 runów. Dwa tryby to url_only (model widzi tylko podane strony) i url_search (może dodatkowo szukać w Google).
Model: gemini-3.7-flash. URL-e numerowane pozycją, nie literą, żeby etykieta nie wędrowała razem z firmą.
Jedna rzecz, którą zrobiłem świadomie i którą polecam każdemu, kto mierzy cokolwiek w LLM-ach: warstwa pomiarowa jest bez modelu. Fan-out, pozycje, statusy pobrania URL-i, tokeny - wszystko liczone wprost z telemetrii API. Dopiero struktura odpowiedzi (kto został polecony, jakie kryteria, jakie braki) idzie przez osobny parser. Dzięki temu najważniejsze liczby w tym tekście nie zależą od tego, czy parser się nie pomylił.
Wynik pierwszy: ranking Google nie przewiduje wyboru
Zwycięzca - solidneprzeprowadzki.pl - zebrał 63 rekomendacje na 100, przy 95-procentowym przedziale ufności 53,2-71,8%. Drugi, przeprowadzki-warszawskie.pl, ma 34% (25,5-43,7%). Przedziały się nie nakładają, więc kolejność na podium nie jest przypadkiem.
Pozostałe trzy firmy zebrały łącznie trzy rekomendacje. Wskaźnik koncentracji HHI wynosi 0,513, co odpowiada mniej więcej dwóm równorzędnym graczom. Model dostał pięciu kandydatów i praktycznie zredukował pole do dwóch.
A teraz to, co jest naprawdę ciekawe. Firma z pierwszej pozycji organicznej została polecona raz na sto. Zwycięzca przyszedł z czwartej. Korelacja rang między pozycją w Google a udziałem rekomendacji wynosi ρ = +0,30 przy p ≈ 0,62 - czyli żadnego wiarygodnego sygnału.
Zanim ktoś zrobi z tego nagłówek „SEO umarło": to nie jest dowód, że pozycja w Google nie ma znaczenia. To dowód, że kiedy wszystkie strony są już na stole, ranking przestaje decydować. W prawdziwym generatywnym wyszukiwaniu jest wcześniejszy etap - model musi te strony najpierw znaleźć, a znajduje je przez indeks Google. SEO decyduje o tym, czy w ogóle wchodzisz do zestawu. To badanie mierzy, co się dzieje potem.
Wynik drugi: ta sama firma, od 5% do 100%
I tu robi się nieprzyjemnie.
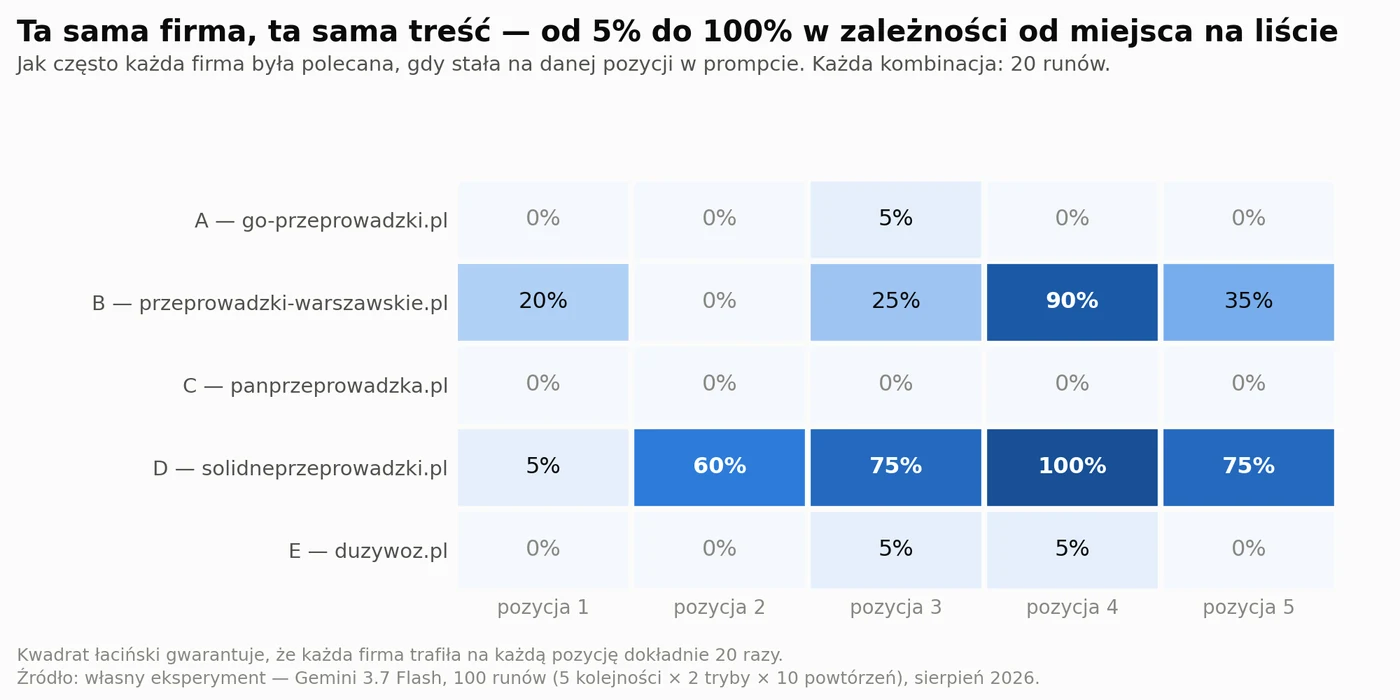
Kwadrat łaciński gwarantuje, że każda firma stała na każdej pozycji dokładnie 20 razy. Gdyby kolejność nie miała znaczenia, każdy wiersz byłby płaski.
Nie jest. Zwycięzca ma 5% na pozycji pierwszej i 100% na czwartej. Ta sama strona, ta sama treść, ten sam prompt - zmienia się wyłącznie miejsce na liście. Drugi w kolejności ma 0% na pozycji drugiej i 90% na czwartej.
W agregacie wygląda to tak:
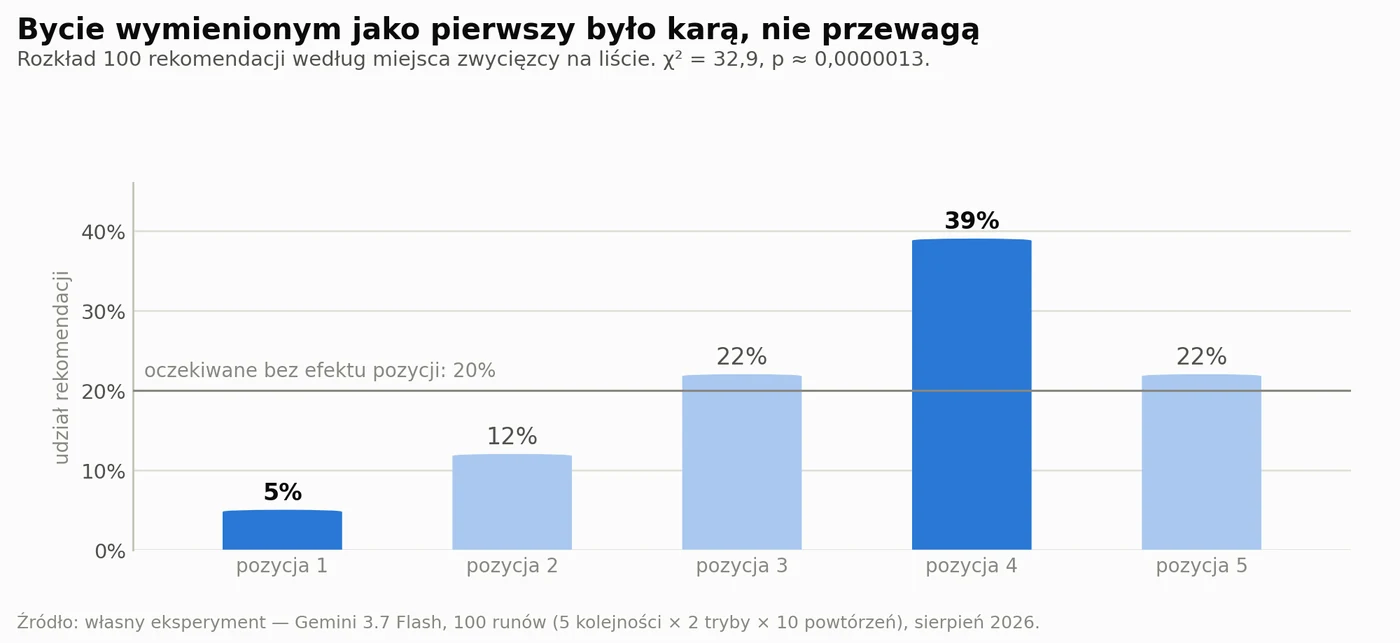
Przy braku efektu kolejności każda pozycja powinna zbierać około 20% rekomendacji. Zbiera 5%, 12%, 22%, 39% i 22%. Test zgodności: χ² = 32,9, p ≈ 0,0000013.
Zwróć uwagę na kształt. To nie jest klasyczne „lost in the middle", o którym pisze się przy długim kontekście - tam zwykle wygrywa początek i koniec. Tutaj początek jest karany najmocniej. Pierwsza pozycja, ta, o którą wszyscy walczą w wynikach organicznych, była w tym zadaniu najgorszym miejscem na liście.
Praktyczna konsekwencja jest brutalna. Jeśli mierzysz „widoczność swojej marki w AI", wpisując do modelu prompt ze statyczną listą konkurentów, to twój wynik w dużej mierze zależy od tego, w jakiej kolejności ich wymieniłeś. Nie od jakości stron. Od kolejności. Pojedynczy pomiar w takim układzie nie mierzy widoczności - mierzy szum, którego sam jesteś autorem.
Minimum metodologiczne to permutowanie kolejności kandydatów i uśrednianie po wielu runach. To nie jest wyrafinowanie. To warunek, żeby liczba w ogóle coś znaczyła.
Co model faktycznie liczył
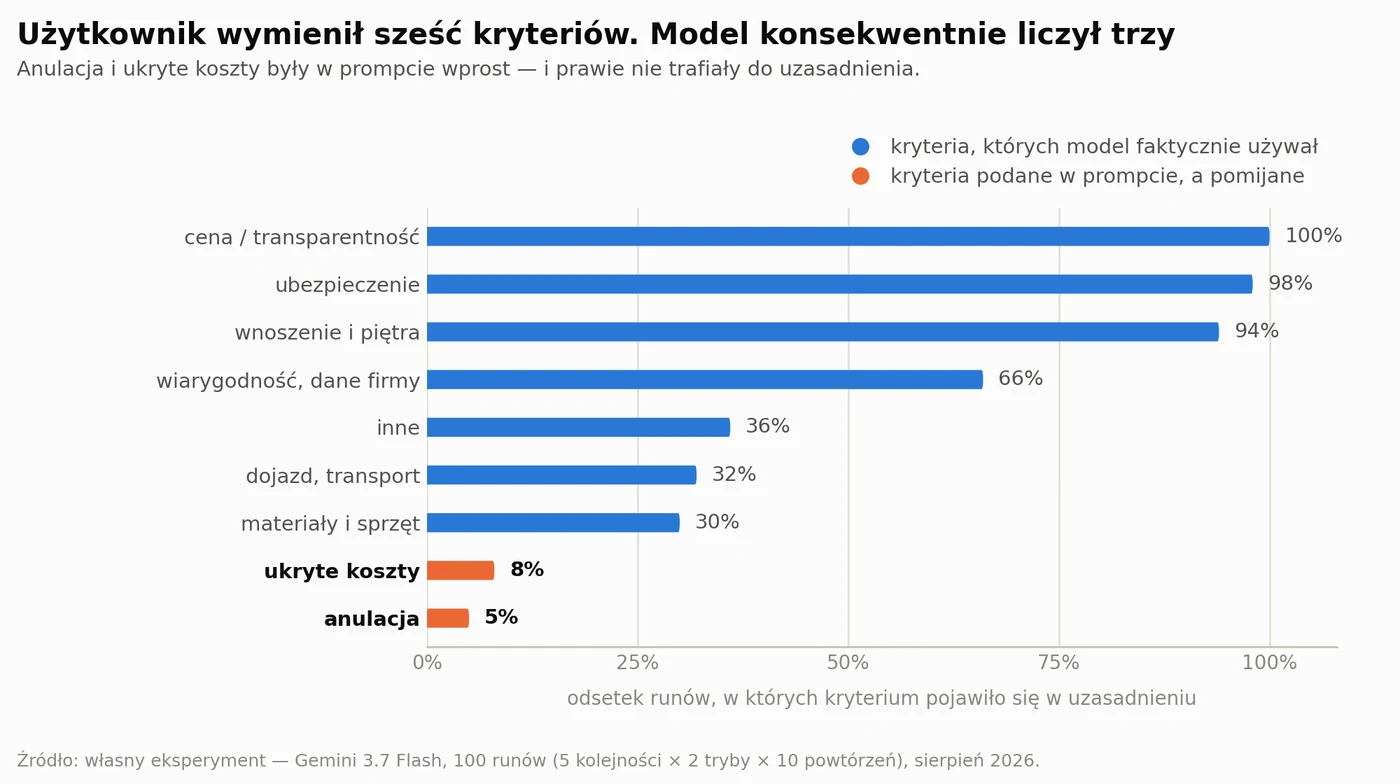
Z 323 unikalnych etykiet w uzasadnieniach wyszło dziewięć kategorii. Trzy dominują: przejrzystość ceny (100% runów), ubezpieczenie (98%), wnoszenie i piętra (94%).
Ale najciekawsze jest to, czego nie ma. Anulacja pojawiła się w 5% runów, ukryte koszty w 8% - mimo że oba kryteria podałem w prompcie wprost. Model dostał listę sześciu rzeczy do sprawdzenia i konsekwentnie operacjonalizował trzy.
To ważne rozróżnienie, bo łatwo je przekręcić. Ten wykres nie pokazuje „uniwersalnych czynników rankingowych Gemini" - pokazuje, które z podanych kryteriów model realnie wykorzystuje, a które ignoruje mimo wyraźnej instrukcji. Gdybym w prompcie nie wspomniał o cenie, wykres wyglądałby inaczej.
Wniosek dla strony jest za to konkretny: przy tej intencji decyzja rozegrała się na cenie, dopłatach za piętra i ubezpieczeniu. Jeśli tych trzech rzeczy nie ma na stronie jawnie, nie bierzesz udziału w porównaniu, w którym model faktycznie porównuje.
Braki informacyjne: sygnał jest, mechanizmu nie ma
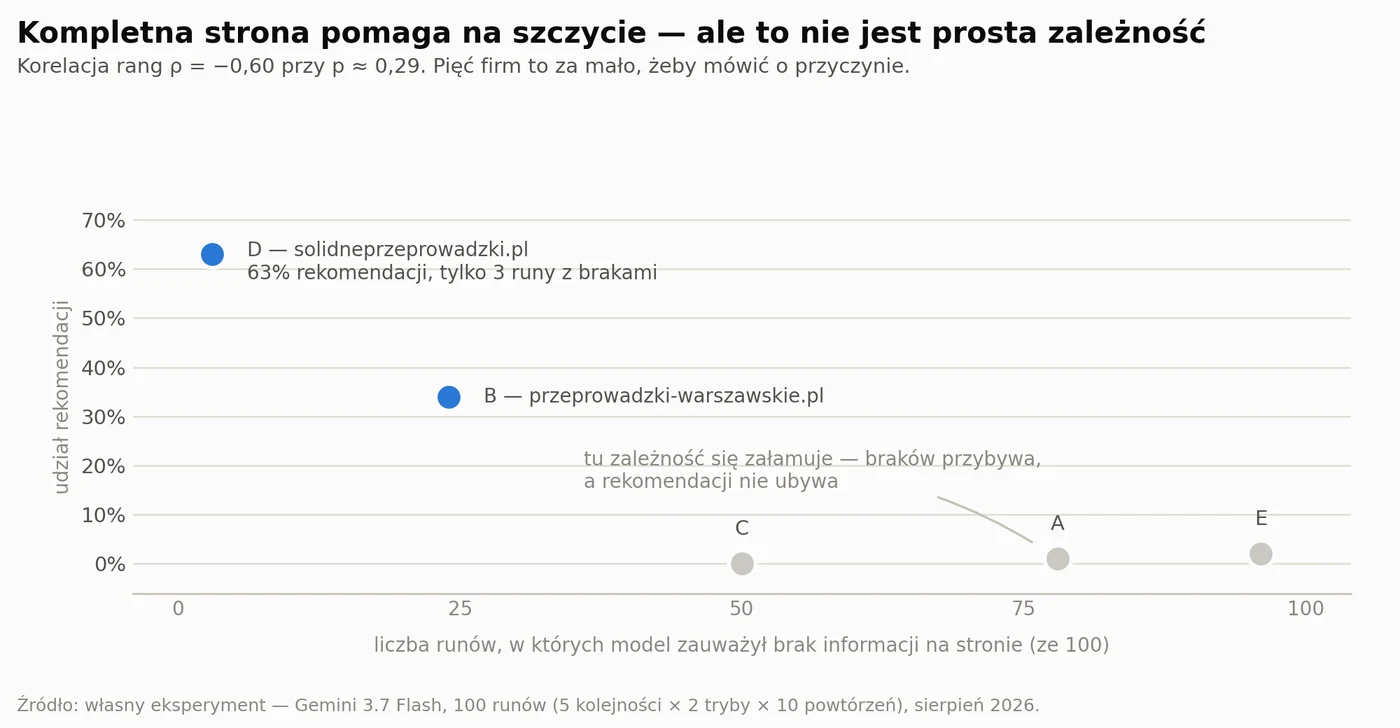
Zwycięzca ma braki informacyjne w 3 runach na 100 i 63% rekomendacji. Drugi - 24 runy i 34%. Wygląda na prostą zależność i kusi, żeby ogłosić: kompletna strona wygrywa.
Nie ogłoszę, bo dane na to nie pozwalają. Poniżej podium zależność się rozjeżdża: firma z 50 runami z brakami ma 0% rekomendacji, ta z 78 ma 1%, a ta z 96 - 2%. Braków przybywa, a rekomendacji nie ubywa. Korelacja rang wynosi ρ = −0,60 przy p ≈ 0,29. Kierunek zgodny z hipotezą, dowodu brak.
Jest jeszcze poważniejszy problem: przy pięciu firmach „firma" jest jednocześnie nośnikiem wszystkiego innego. Innej marki, innego typu strony, innej reputacji w sieci, innego języka. Nie da się rozdzielić kompletności informacji od reszty, bo wszystko zmienia się razem.
To jest różnica między badaniem diagnostycznym a przyczynowym. To pierwsze mówi, gdzie szukać. Drugie wymaga innego eksperymentu - wrócę do tego na końcu.
Wynik trzeci, którego się nie spodziewałem: liczy się typ strony
W trybie url_search model szukał w Google w 50 runach na 50. Zawsze. Średnio 3,9 zapytania na run, od 2 do 11. Mimo że dostał pięć konkretnych stron do przeczytania.
Naturalna hipoteza brzmi: doszukuje te firmy, o których strony mówią za mało. Sprawdziłem - i nie.
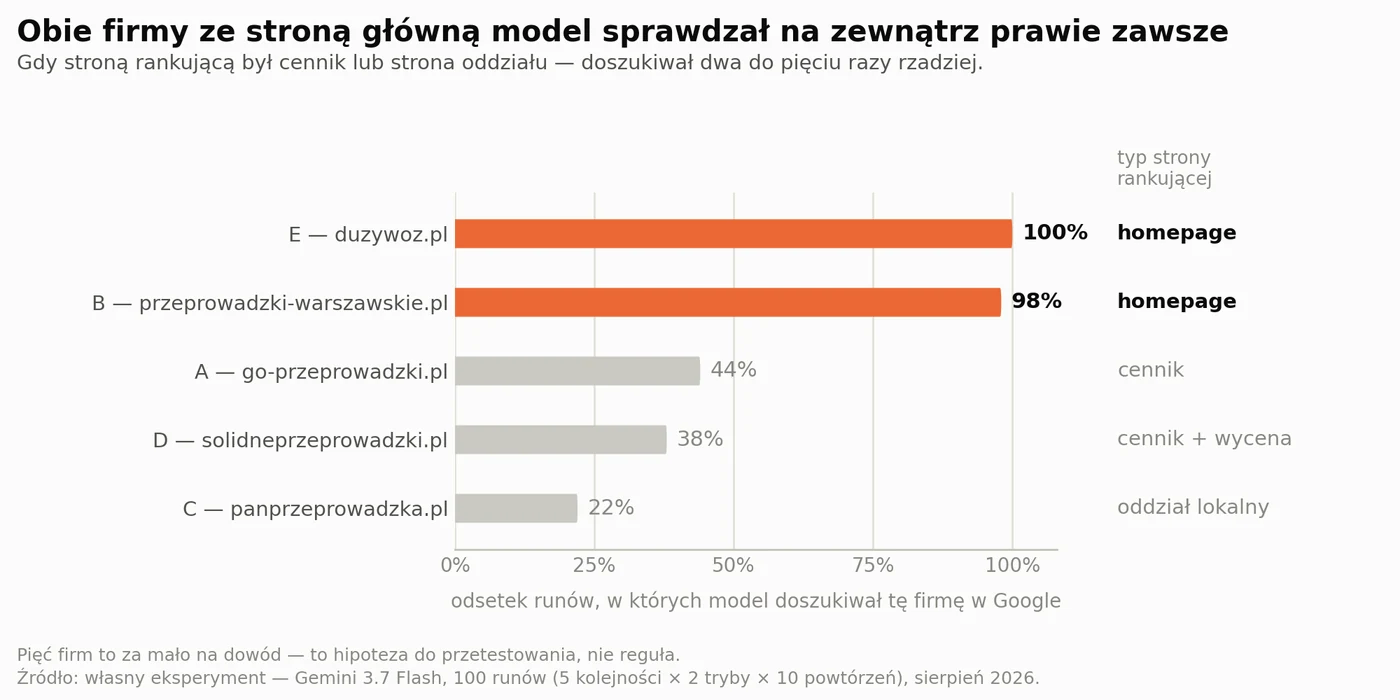
Firma z 24 runami z brakami była doszukiwana w 98% przypadków. Firma z 50 brakami - w 22%. Korelacja braków z fan-outem to ρ = +0,50 przy p ≈ 0,39, czyli nic.
Ale kiedy posortujesz te same firmy po typie strony rankującej, obraz robi się jednoznaczny. Obie firmy, których stroną rankującą była strona główna, były doszukiwane w 98% i 100% runów. Wszystkie trzy, które miały stronę wewnętrzną - cennik, cennik z wyceną, stronę oddziału - w 22-44%. Zero nakładania się między grupami.
Pięć firm to za mało na dowód i mówię to wprost. Ale jako hipoteza jest to najbardziej użyteczna rzecz w całym eksperymencie:
Strona główna nie zaspokaja modelu. Strona ofertowa - tak.
A to ma konsekwencję, która wykracza poza rekomendację. Kiedy model idzie doszukać twoją firmę w Google, narrację o tobie buduje z cudzych źródeł: opinii, katalogów, porównywarek, forów. Tracisz kontrolę nad tym, co o tobie zostanie powiedziane. Nie dlatego, że twoja strona jest zła - dlatego, że nie odpowiada na pytanie, które model właśnie sobie zadał.
Czy dostęp do wyszukiwarki zmienia wynik
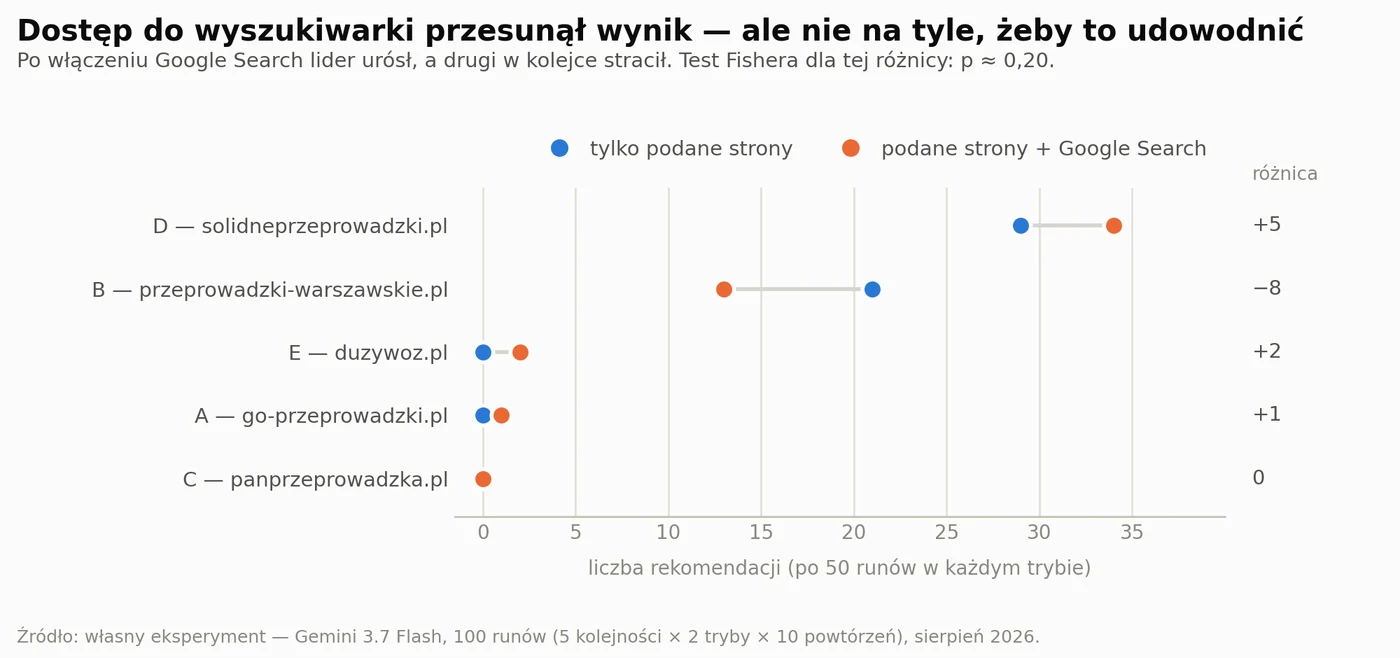
W trybie zamkniętym lider miał 29 rekomendacji, a drugi 21. Po włączeniu Google Search lider urósł do 34, drugi spadł do 13. Kierunek ciekawy - dodatkowe informacje z sieci pomogły temu, kto już wygrywał.
Test Fishera dla tej różnicy daje p ≈ 0,20. Czyli: sygnał jest, dowodu nie ma. Przy 50 runach na tryb nie mogę twierdzić, że sam dostęp do wyszukiwarki przesuwa rekomendację.
Czego to badanie nie dowodzi
Piszę tę sekcję, bo bez niej reszta jest reklamą, nie badaniem.
Jedna fraza, jedna branża, jeden dzień, jeden model. To case study. Nie ekstrapoluj na inne rynki bez powtórzenia.
Kwadrat łaciński równoważy pozycję, ale nie sąsiedztwo. Pięć cyklicznych kolejności to nie to samo co 120 możliwych permutacji pięciu elementów. Efekt pozycji jest w tych danych bezsporny, ale „premia czwartej pozycji" jako konkretna liczba - już nie. Do tego potrzeba losowych permutacji.
Struktura odpowiedzi pochodzi z parsera LLM. Kto został polecony, jest pewne. Lista kryteriów i braków ma własny szum anotatora.
Model nie zawsze czyta podane strony. W trzech runach urlContextMetadata wróciło puste dla wszystkich pięciu URL-i naraz - model zignorował to, co mu dałem, i poszedł prosto w Google. Wszystkie trzy w trybie url_search. To nie jest problem z crawlability żadnej z tych stron, tylko zmienność użycia narzędzia. I osobne ostrzeżenie dla każdego, kto buduje coś produkcyjnego na url_context.
Co z tego wynika dla GEO
Po pierwsze: przestań mierzyć jednym strzałem. Jeśli twoje narzędzie do „AI visibility" odpytuje model raz i pokazuje wynik, to pokazuje ci los. W tym eksperymencie sama kolejność kandydatów potrafiła przesunąć wynik tej samej firmy z 5% na 100%. Sensowny pomiar to wiele powtórzeń, wiele permutacji kolejności i wiele parafraz intencji - a raportowana liczba to udział rekomendacji, nie „zostaliśmy wybrani".
Po drugie: wysoka pozycja w Google nie jest biletem do rekomendacji. Jest biletem do zestawu. To dwa różne etapy i optymalizuje się je inaczej. Pierwszy klasycznym SEO, drugi - kompletnością informacji dokładnie w punktach, w których klient podejmuje decyzję.
Po trzecie: sprawdź, co jest twoją stroną rankującą. Jeśli na frazy komercyjne rankuje ci strona główna, to w tym eksperymencie oznaczało prawie stuprocentową szansę, że model pójdzie doszukać twoją firmę na zewnątrz. Strona ofertowa z cenami tego nie wywoływała. Przy pięciu firmach to hipoteza - ale sprawdzenie jej u siebie kosztuje jedno popołudnie.
Po czwarte: pisz jawnie to, czego model szuka. Nie „wyceniamy indywidualnie", tylko widełki i sposób liczenia. Nie „towar jest ubezpieczony", tylko suma. Nie „możliwe dopłaty", tylko tabela za piętro bez windy. Każda luka to nie tylko punkt minus - to zaproszenie, żeby model uzupełnił ją cudzym tekstem.
Jak to porządnie rozstrzygnąć
Ten eksperyment mówi, gdzie szukać. Nie mówi, co powoduje. Rozstrzygnięcie wymaga ablacji, nie kolejnego porównania pięciu różnych firm.
Bierzesz jedną stronę i przygotowujesz kontrolowane warianty: bazowy, plus jawna suma ubezpieczenia, plus tabela dopłat za piętra, plus zasady anulacji, plus pełny cennik - i kombinacje. Reszta treści identyczna. Dopiero wtedy mierzysz przyczynowy przyrost szansy na rekomendację po dodaniu konkretnej informacji.
Do tego dwie rzeczy: losowe permutacje zamiast pięciu cyklicznych kolejności, i rozbicie fan-outu na typy zapytań - czy model szuka opinii, danych rejestrowych, cen, czy po prostu nazwy. Obecne „czy firma została doszukana" jest zbyt szerokie, żeby powiedzieć, czy wyszukiwanie kandydatowi pomogło, czy zaszkodziło.
Ten sam model, który tutaj wybiera firmę, w innym moim teście coraz rzadziej w ogóle sięga do sieci - a to znaczy, że okno na bycie źródłem się zawęża. Tym bardziej warto wiedzieć, co je otwiera.
Aneks: pełne wyniki
Rekomendacje (100 runów)
| firma | domena | pozycja w Google | typ strony | rekomendacje | url_only |
url_search |
|---|---|---|---|---|---|---|
| D | solidneprzeprowadzki.pl | 4 | cennik + wycena | 63% | 29 | 34 |
| B | przeprowadzki-warszawskie.pl | 2 | homepage | 34% | 21 | 13 |
| E | duzywoz.pl | 5 | homepage | 2% | 0 | 2 |
| A | go-przeprowadzki.pl | 1 | cennik | 1% | 0 | 1 |
| C | panprzeprowadzka.pl | 3 | oddział lokalny | 0% | 0 | 0 |
Recommendation rate wg pozycji w prompcie
| firma | poz. 1 | poz. 2 | poz. 3 | poz. 4 | poz. 5 |
|---|---|---|---|---|---|
| A | 0% | 0% | 5% | 0% | 0% |
| B | 20% | 0% | 25% | 90% | 35% |
| C | 0% | 0% | 0% | 0% | 0% |
| D | 5% | 60% | 75% | 100% | 75% |
| E | 0% | 0% | 5% | 5% | 0% |
| razem | 5% | 12% | 22% | 39% | 22% |
Braki informacyjne i fan-out
| firma | runów z brakiem info | doszukiwana w Google | rekomendacje |
|---|---|---|---|
| D | 3 | 38% | 63% |
| B | 24 | 98% | 34% |
| C | 50 | 22% | 0% |
| A | 78 | 44% | 1% |
| E | 96 | 100% | 2% |
Statystyki
| miara | wartość |
|---|---|
| Rozkład rekomendacji po firmach | χ² = 156,5, p < 10⁻³¹ |
| Rozkład rekomendacji po pozycjach | χ² = 32,9, p ≈ 1,25 × 10⁻⁶ |
| Koncentracja HHI | 0,513 (≈ 1,95 efektywnego gracza) |
| Pozycja w Google ↔ rekomendacje | ρ = +0,30, p ≈ 0,62 |
| Braki informacyjne ↔ rekomendacje | ρ = −0,60, p ≈ 0,29 |
| Braki informacyjne ↔ fan-out | ρ = +0,50, p ≈ 0,39 |
url_only vs url_search (B kontra D) |
test Fishera, p ≈ 0,20 |
Runy z wyszukiwaniem w trybie url_search |
50 / 50 |
| Zapytania fan-out na run | min 2 · mediana 4 · śr. 3,9 · maks. 11 |
| Runy z kompletem 5/5 pobranych stron | 97 / 100 |
Wszystkie metryki deterministyczne policzone wprost z telemetrii Gemini API, bez udziału modelu w warstwie pomiarowej.