Gemini 3.7 Flash przestał szukać. To ważniejsze niż to, że przyspieszył
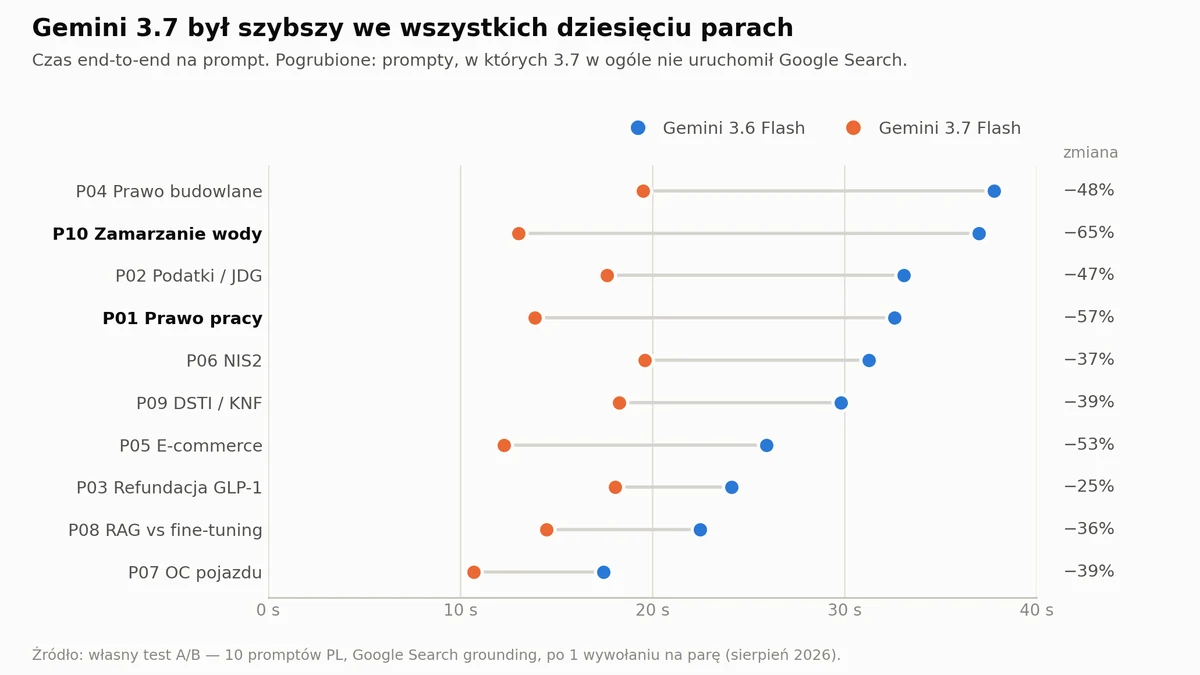
Przepuściłem dziesięć polskich promptów przez Gemini 3.6 Flash i 3.7 Flash z włączonym Google Search grounding. Nowszy model okazał się szybszy w każdej parze - ale połowa tej przewagi bierze się stąd, że rzadziej sprawdza fakty. Dla SEO to nie jest ta sama wiadomość.
Większość porównań 3.6 vs 3.7, jakie widziałem, traktuje temat jak zakup narzędzia: który model taniej napisze brief, który lepiej wygeneruje JSON-LD. To sensowne pytanie, ale nie najważniejsze. Jeśli pracujesz nad widocznością w generatywnym wyszukiwaniu, ciekawsze jest coś innego: jak model decyduje, czy w ogóle sięgnąć do sieci, ile zapytań wyśle i czyje strony zacytuje. Bo to jest dokładnie ten mechanizm, który decyduje, czy twoja strona pojawia się w odpowiedzi.
Zmierzyłem to.
Jak to zmierzyłem
Dziesięć promptów po polsku, po jednym z różnych dziedzin: prawo pracy, podatki i JDG, refundacja leków, prawo budowlane, e-commerce, NIS2, ubezpieczenia komunikacyjne, architektura AI, kredyty hipoteczne i fizyka. Wszystkie krótkie - 92 do 118 znaków - i w większości takie, które powinny wymusić grounding, bo dotyczą stanu prawnego albo bieżących regulacji.
Każdy prompt poszedł do obu modeli z włączonym Google Search grounding. Z każdej odpowiedzi zebrałem pełną telemetrię: czas end-to-end, tokeny wejścia, tokeny myślenia, tokeny odpowiedzi, informację czy Search się uruchomił, listę sub-zapytań fan-out, listę zacytowanych domen i liczbę grounding supports.
Ograniczenie, które trzeba powiedzieć na wstępie: jedno wywołanie na parę. Dziesięć par to nie jest benchmark populacyjny, a przy jednym strzale nie da się oddzielić różnicy między modelami od naturalnej zmienności retrievalu. Wracam do tego pod koniec - bo akurat w części dotyczącej źródeł to ograniczenie jest krytyczne.
Szybkość: realna, ale nie taka, jak wygląda
3.7 był szybszy we wszystkich dziesięciu parach. Średnio 15,74 s wobec 29,16 s, czyli −46,0%. Mediana −47,4%. Średnia różnica to −13,4 s, 95% przedział ufności od −17,6 do −9,3 s, sparowany test t daje p ≈ 0,000045.
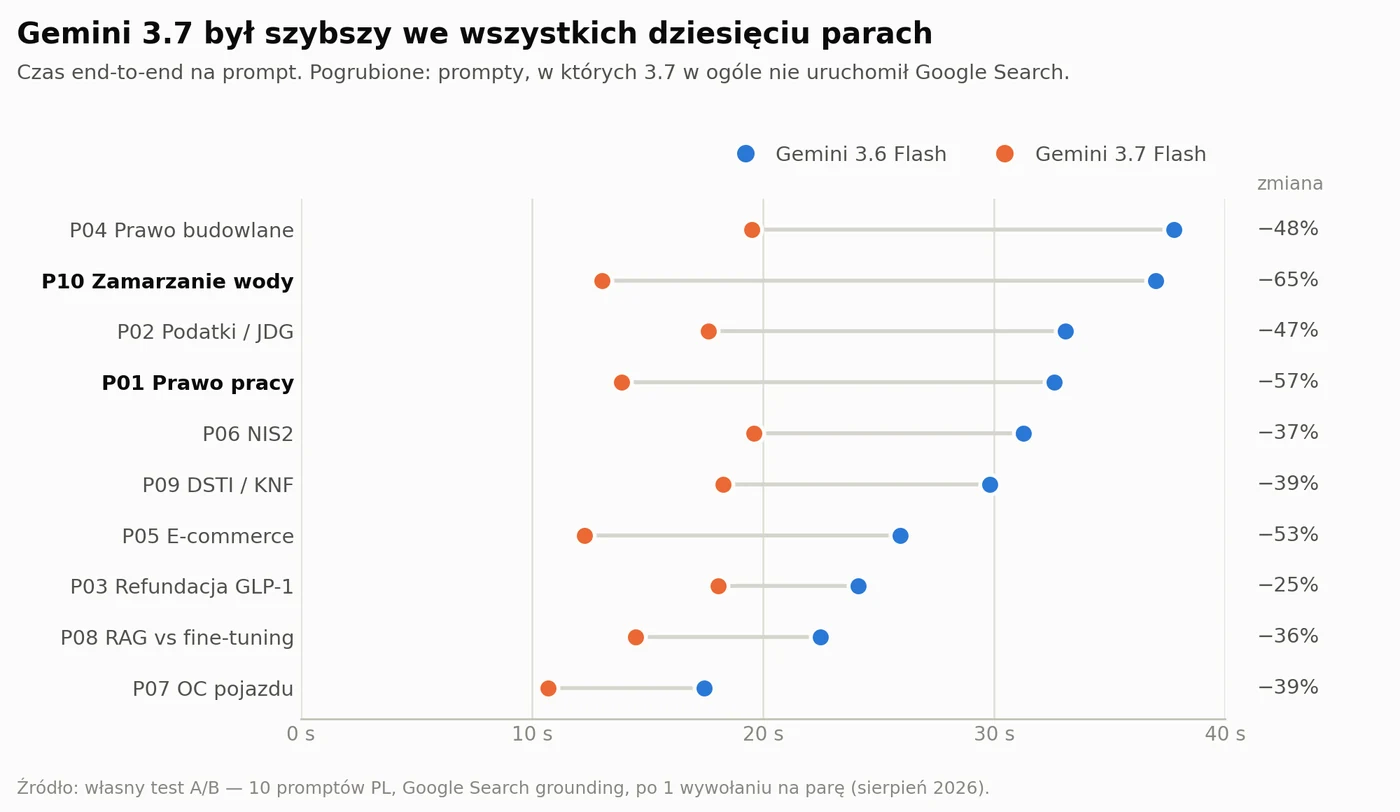
Efekt jest bardzo spójny. Ale spójrz na dwa pogrubione wiersze: P01 i P10 to prompty, w których 3.7 w ogóle nie uruchomił Google Search, a 3.6 uruchomił. To są jednocześnie dwie największe redukcje czasu w całym zbiorze (−57% i −65%). Nie da się ich zaliczyć na konto „szybszej inferencji" - model po prostu pominął cały etap pobierania danych.
Więc policzyłem to jeszcze raz, z kontrolą:
- bez P01 i P10 (czyli tylko pary, w których oba modele zachowały się tak samo wobec Search): 27 745 → 16 316 ms, −41,2%
- sam P08, gdzie żaden model nie szukał - czysta inferencja, zero groundingu: 22 474 → 14 489 ms, −35,5%
Efekt przeżywa kontrolę i to jest dobra wiadomość. 3.7 naprawdę jest szybszy, nie tylko bardziej pobieżny. Ale prawdziwa liczba to około −35 do −41%, nie −46%.
Tokeny: to samo zjawisko
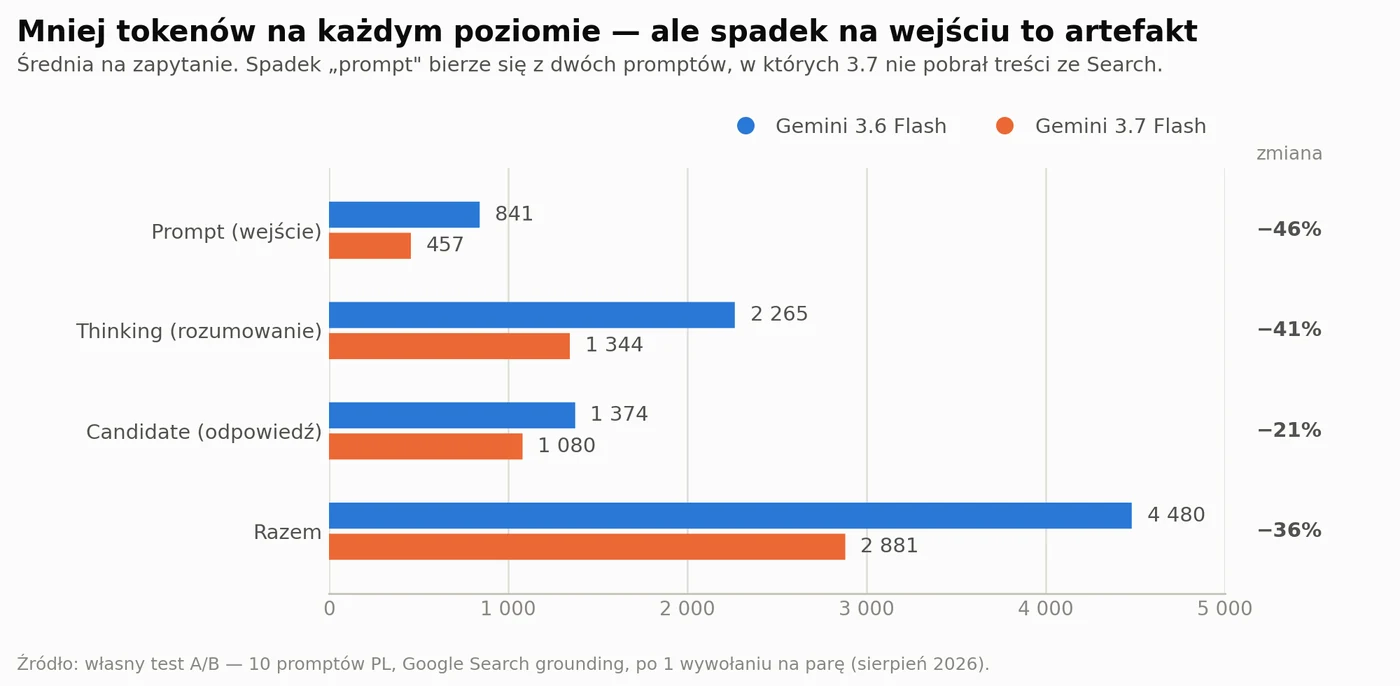
Thinking tokens spadły o 40,6%, tokeny odpowiedzi o 21,4%, razem o 35,7%. Długość tekstu odpowiedzi spadła o 18,4%, a długość zwracanych podsumowań myślenia o 19,7% - czyli tekst „thought" nie kurczy się proporcjonalnie do thoughtsTokens. To akurat spójne z tym, że API zwraca podsumowania rozumowania, a nie surowy monolog; nie warto traktować tych dwóch rzeczy jako tej samej miary.
Uwaga na słupek „prompt". Spadek −45,7% wygląda spektakularnie, ale to artefakt: promptTokens zawierają wstrzykniętą treść ze Search. W P01 3.6 ma 1 615 tokenów wejścia, a 3.7 dwadzieścia siedem - przy identycznym tekście użytkownika. Po odjęciu dwóch par bez Search zostaje 626 → 564, czyli −9,9%.
Koszt: 34% to za dużo obiecane
Przy obecnej cenie promocyjnej, identycznej dla obu modeli, tokeny z tego eksperymentu wychodzą 9,43 na tysiąc zapytań. Ale skoro wiemy już, skąd bierze się część różnicy:
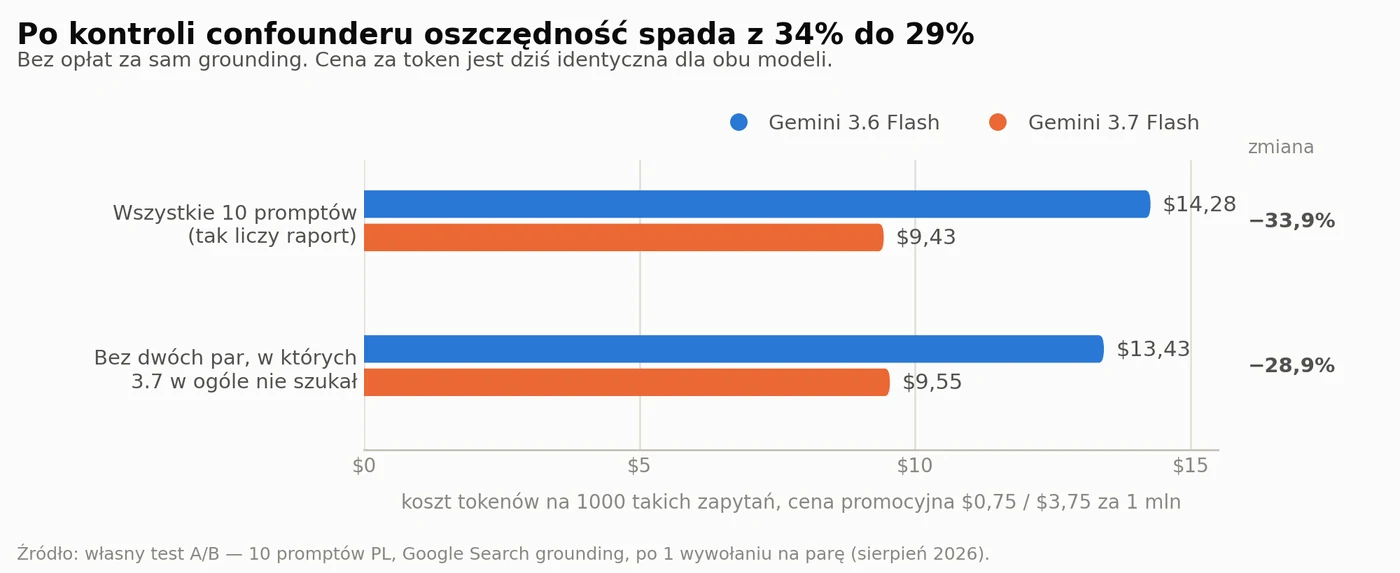
Po kontroli confounderu oszczędność spada z 33,9% do 28,9%. Nadal warto, tylko nie tyle, ile mówi surowa średnia. I to bez opłat za sam grounding - a te idą w drugą stronę tej samej logiki: mniej uruchomień Search to mniej płatnych requestów, znowu nie dlatego, że model jest efektywniejszy, tylko dlatego, że rzadziej sprawdza.
Sedno: model coraz rzadziej sięga do sieci
Tu zaczyna się część, która powinna interesować każdego, kto pracuje nad widocznością.
3.6 uruchomił Google Search w 9 z 10 zapytań. 3.7 w 7 z 10.
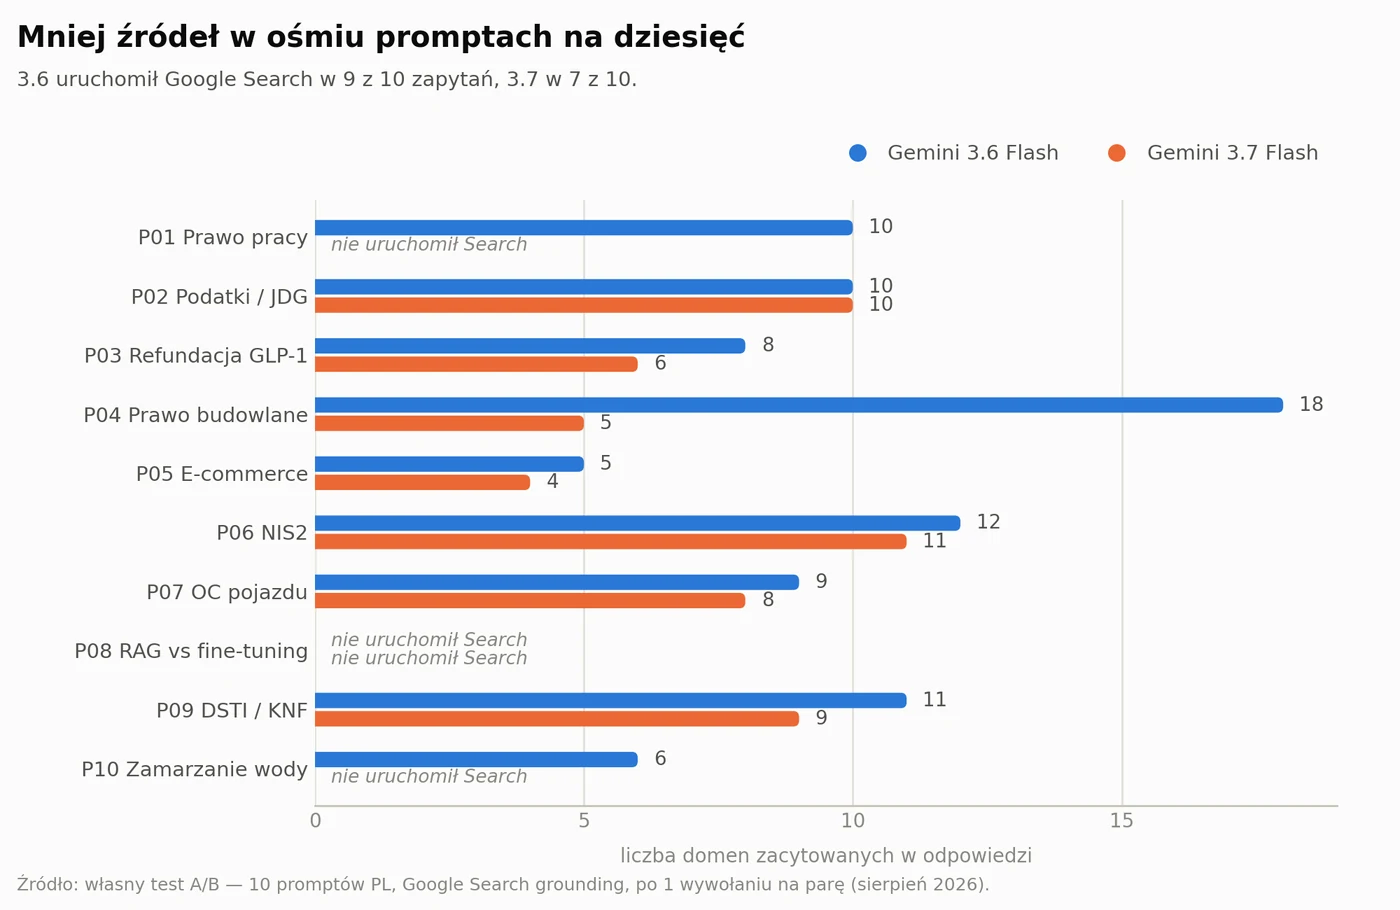
Pominięte prompty to nie były jakieś ogólniki. P01 to pytanie o to, kiedy pracodawca może odmówić urlopu na żądanie - pytanie o stan prawny, na które 3.7 odpowiedział wyłącznie z pamięci parametrycznej, nie cytując ani jednego źródła. P10 to pytanie o zamarzanie wody morskiej, gdzie 3.6 sięgnął po Met Office, Cambridge i AMS, a 3.7 odpowiedział z siebie.
Deklarowany knowledge cutoff obu modeli to okolice marca 2026, przy czym producent zastrzega, że dla części dziedzin wiedza może odpowiadać nawet wcześniejszemu okresowi. Odpowiadanie na pytanie o polskie prawo pracy bez zaglądania do sieci jest więc realnym ryzykiem, a nie teoretycznym.
Ta sama różnica widać w fan-oucie. Średnio 1,90 → 1,20 sub-zapytania, czyli −36,8%. Ale znowu: ta średnia jest ciągnięta przez dwa zera. Wśród siedmiu par, w których oba modele faktycznie szukały, jest 2,14 → 1,71, czyli −20% - i w jednym przypadku (P07) 3.7 wygenerował więcej sub-zapytań niż 3.6. Przy takim rozrzucie i n=7 „3.7 robi mniej fan-outu" to jeszcze nie jest ustalenie.
Co się dzieje z pulą źródeł
Tu jest liczba, którą uważam za najważniejszą w całym eksperymencie.
W tych samych dziesięciu promptach 3.6 wygenerował 89 cytowań, 3.7 - 53. Grounding supports, czyli faktyczne zakotwiczenia fragmentów odpowiedzi w źródłach, spadły z 166 do 99.
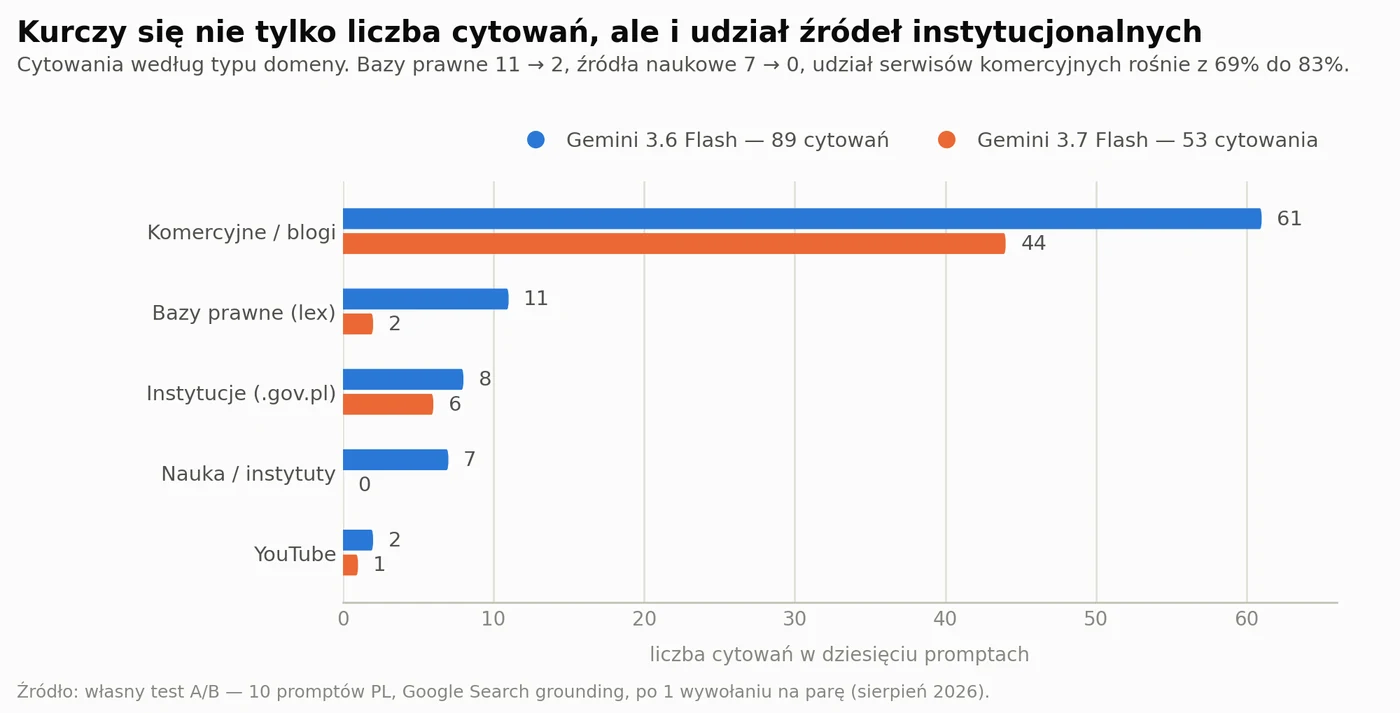
Ale nie chodzi tylko o liczbę. Zmienia się skład. Cytowania z baz prawnych spadły z 11 do 2. Źródła naukowe i instytutowe - z 7 do zera. Udział serwisów komercyjnych i blogów wzrósł z 69% do 83%.
A rotacja samych domen jest jeszcze ostrzejsza:
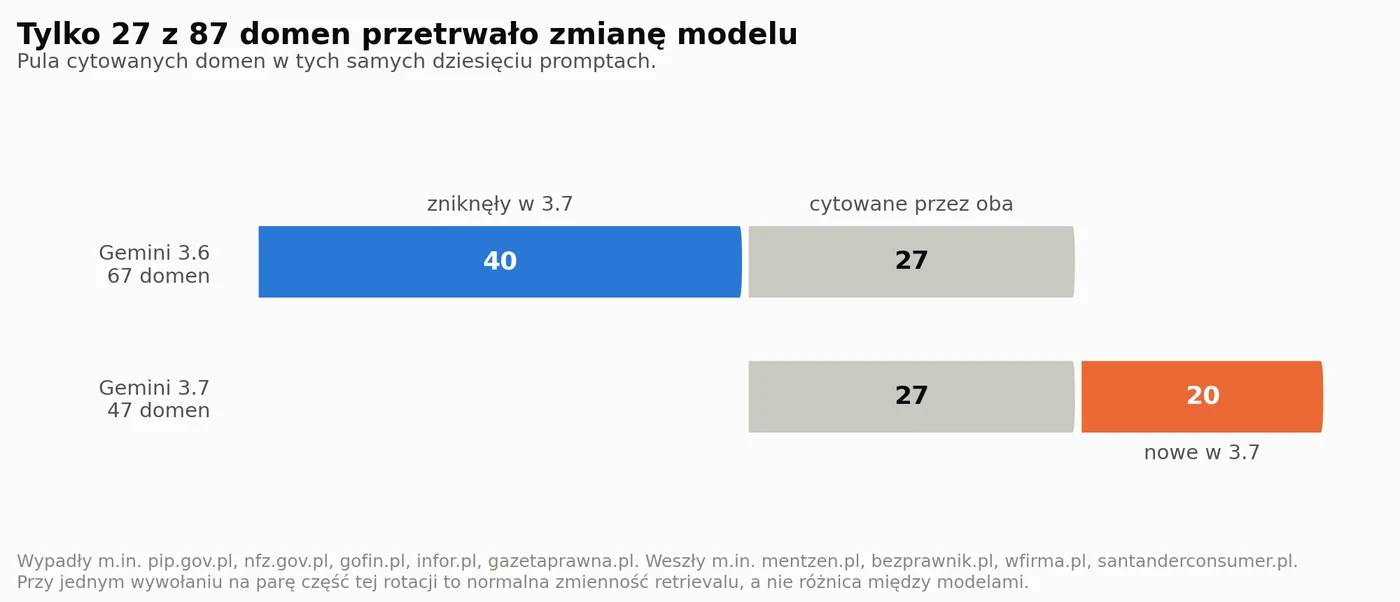
Na 87 unikalnych domen w całym zbiorze tylko 27 zostało zacytowanych przez oba modele. Czterdzieści zniknęło, dwadzieścia pojawiło się od nowa.
Wypadły między innymi pip.gov.pl, nfz.gov.pl, gofin.pl, infor.pl, gazetaprawna.pl, prawo.pl, lexlege.pl. Weszły mentzen.pl, bezprawnik.pl, wfirma.pl, fakturaxl.pl, santanderconsumer.pl, gethome.pl, pragmago.pl.
Co to znaczy dla GEO
Zastrzeżenie, które od 16 sierpnia trzeba zniuansować. Do niedawna dało się uczciwie powiedzieć, że gemini-3.7-flash z publicznego API nie ma nic wspólnego z rankingiem Google Search. Teraz to już nie jest takie proste: Google ogłosiło, że Gemini 3.7 Flash wchodzi do AI Mode - na razie dla subskrybentów AI Pro i Ultra i tylko po angielsku. Rajan Patel zapowiedział to wprost („Next stop for Gemini 3.7 Flash? Google Search!"), a Robby Stein dodał o lepszym rozumieniu intencji zapytania.
Granica tego, co wiemy, jest jednak ważna: nie potwierdzono, że model w AI Mode to ten sam checkpoint co publiczny API, na którym robiłem te pomiary. AI Overviews i klasyczny ranking wciąż stoją na indeksie, core ranking systems i własnych modelach Google - jeden Flash ich nie zastępuje. Ale wniosek idzie w jedną stronę: rodzina modeli, którą tu zmierzyłem, realnie zasila generatywne funkcje wyszukiwarki, a nie tylko żyje w API dla developerów. I jej kierunek jest jednoznaczny: mniej zapytań do sieci, mniej pobranych źródeł, więcej odpowiadania z wiedzy własnej.
Jeśli ten kierunek się utrzyma, konsekwencja dla widoczności jest arytmetyczna: liczba slotów cytowania na jedno zapytanie się kurczy. W moim zbiorze o 40%. Mniej miejsc oznacza ostrzejszą konkurencję o każde z nich - i większą premię za bycie w wąskiej grupie źródeł, po które model sięga, gdy już zdecyduje się sięgnąć.
A gdy już sięgnie i musi wybrać jedną firmę z zestawu, o wyborze decyduje coś zupełnie innego niż ranking Google - sprawdziłem to w osobnym eksperymencie.
Druga konsekwencja jest mniej oczywista i idzie w poprzek intuicji. Skoro w tej próbce z puli wypadły przede wszystkim serwisy instytucjonalne i prawne, a weszły komercyjne, to dla komercyjnego wydawcy zmiana jest potencjalnie korzystna. Przekonanie „w tematach YMYL model i tak zacytuje .gov.pl, nie mam szans" w tych danych się nie broni. Ale to samo zjawisko oznacza, że odpowiedzi są słabiej zakotwiczone w źródłach pierwotnych - co jest problemem jakościowym dla użytkownika i ryzykiem dla każdego, kto na takiej odpowiedzi buduje treść.
Trzecia rzecz, praktyczna od zaraz: jeśli budujesz cokolwiek produkcyjnego na tym API, nie zostawiaj decyzji o groundingu modelowi. 3.7 pominął Search w pytaniu o kodeks pracy. Wymuszaj retrieval politykalnie - dla klas treści zależnych od czasu, prawa, cen, refundacji, regulacji - zamiast liczyć na to, że nowszy model sam wie lepiej.
Czego te dane nie mówią
Trzy rzeczy, których nie da się z tego wyciągnąć, a łatwo je nadinterpretować.
Po pierwsze, rotacja domen jest w dużej mierze nierozstrzygnięta. W osobnym eksperymencie - 50 powtórzeń tego samego promptu - mierzyłem, jak bardzo pula źródeł zmienia się między identycznymi wywołaniami. Jaccard źródeł wynosił 0,785 przy tym samym zapytaniu i tej samej ścieżce rozumowania, ale spadał do 0,284, gdy model wybierał inną ścieżkę. Przy jednym strzale na parę nie jestem w stanie odróżnić różnicy między modelami od tej rotacji. Wykres 4 pokazuje hipotezę, nie wynik.
Po drugie, nie zmierzyłem poprawności. Ani razu. Wiem, że 3.7 był szybszy i tańszy, i że rzadziej cytował. Nie wiem, czy odpowiedzi były trafniejsze. Odpowiedź na pytanie o urlop na żądanie wygenerowana bez jednego źródła może być całkowicie poprawna albo cicho przestarzała - z tych danych tego nie widać.
Po trzecie, temperatura. W metryce eksperymentu widnieje temperature=1.0, ale w generacji Gemini 3 klasyczne parametry samplingowe są przestarzałe i, zależnie od warstwy API, mogą być ignorowane. Nie traktuj tej wartości jako kontrolowanego ustawienia losowości - bo prawdopodobnie nią nie jest.
Dla kontekstu: co mówią oficjalne benchmarki
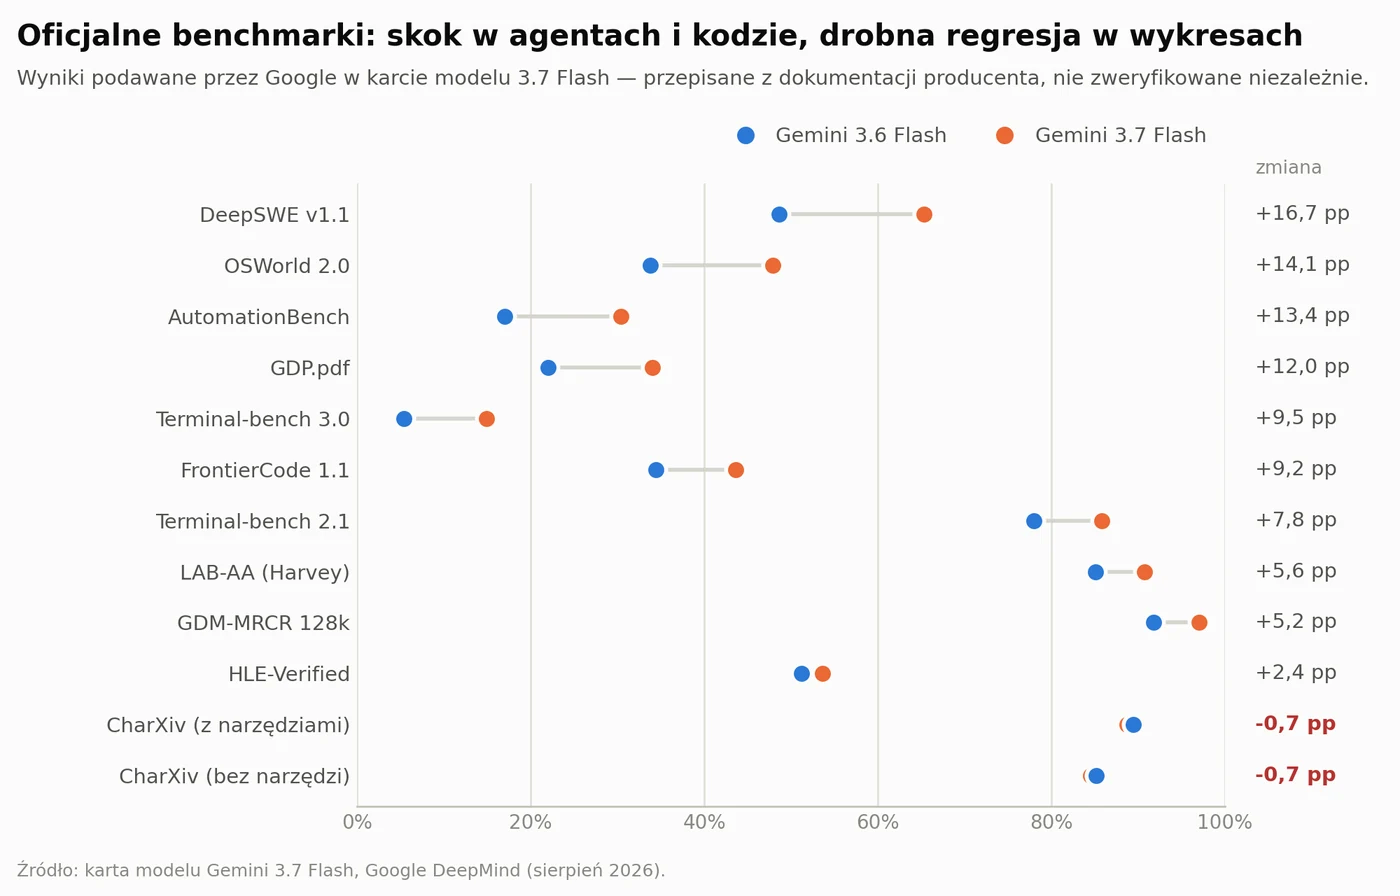
Wyniki z karty modelu producenta układają się w spójny obraz: bardzo duże skoki tam, gdzie model musi długo planować i używać narzędzi, i drobna regresja w analizie złożonych wykresów. To pasuje do deklarowanego celu wydania.
Zaznaczam wyraźnie: te liczby przepisałem z dokumentacji Google i nie zweryfikowałem ich niezależnie. W przeciwieństwie do wszystkiego powyżej, gdzie każda wartość pochodzi z surowego pliku, który sam wygenerowałem.
Jak to porządnie rozstrzygnąć
Ten eksperyment jest wystarczający dla latencji i tokenów, i niewystarczający dla źródeł. Domknięcie jest tanie:
Te same dziesięć promptów × dziesięć powtórzeń × dwa modele = 200 wywołań. Pół godziny i kilka złotych. Z tego da się policzyć:
- rozkład
search_triggeredper prompt, z przedziałami Wilsona - czy 7/10 to sygnał, czy szum - Jaccard puli źródeł: między powtórzeniami tego samego modelu vs między modelami. Jeśli międzymodelowy jest istotnie niższy, różnica jest realna. Jeśli porównywalny - cała sekcja o rotacji domen jest o niczym
- citation rate per domena, z jawnym progiem decyzyjnym ustalonym przed zebraniem danych
Do tego druga seria, kontrolowana, bez Search i bez tool calls, żeby rozdzielić koszt prefillu, rozumowania i dekodowania od kosztu narzędzi.
Wniosek
Gemini 3.7 Flash jest szybszy, tańszy i mocniejszy w zadaniach agentowych. Jako domyślny model do pracy z treścią - tak, migracja ma sens.
Ale nagłówek „−46% latencji" jest o kilka punktów za optymistyczny, a nagłówek „−34% kosztu" o pięć. A najważniejsza zmiana nie jest w ogóle o wydajności: nowszy model rzadziej sięga do sieci i cytuje mniej źródeł. W środowisku, w którym widoczność marki oznacza bycie zacytowanym, to nie jest optymalizacja. To zmiana warunków gry, i to w stronę, w której miejsc przy stole jest mniej.
Aneks: pełne zestawienie metryk
| Metryka (średnia z 10 promptów) | Gemini 3.6 | Gemini 3.7 | Zmiana |
|---|---|---|---|
| Latencja end-to-end | 29 157 ms | 15 744 ms | −46,0% |
| Latencja, mediana | 30 547 ms | 16 056 ms | −47,4% |
| Latencja, bez dwóch par bez Search | 27 745 ms | 16 316 ms | −41,2% |
| Latencja, sam P08 (zero groundingu) | 22 474 ms | 14 489 ms | −35,5% |
| Tokeny promptu | 841,0 | 457,0 | −45,7% |
| Tokeny promptu, bez dwóch par bez Search | 626,1 | 564,2 | −9,9% |
| Tokeny myślenia | 2 264,7 | 1 344,1 | −40,6% |
| Tokeny odpowiedzi | 1 373,9 | 1 080,1 | −21,4% |
| Tokeny razem | 4 479,6 | 2 881,2 | −35,7% |
| Długość odpowiedzi | 3 822 zn. | 3 121 zn. | −18,4% |
| Długość podsumowania myślenia | 5 750 zn. | 4 619 zn. | −19,7% |
| Search uruchomiony | 9 / 10 | 7 / 10 | −20 pp |
| Sub-zapytania fan-out | 1,90 | 1,20 | −36,8% |
| Fan-out, tylko pary z Search w obu | 2,14 | 1,71 | −20,0% |
| Cytowane źródła | 8,9 | 5,3 | −40,4% |
| Grounding supports | 16,6 | 9,9 | −40,4% |
| Cytowania ogółem (suma) | 89 | 53 | −40,4% |
| Unikalne domeny (suma) | 67 | 47 | −29,9% |
| Koszt / 1000 zapytań | $14,28 | $9,43 | −33,9% |
| Koszt / 1000, bez dwóch par bez Search | $13,43 | $9,55 | −28,9% |
Wszystkie wartości policzone z surowego pliku JSONL z tego eksperymentu. Ceny według stawki promocyjnej 3,75 za milion tokenów wyjścia, obowiązującej dla obu modeli; koszt nie obejmuje opłat za grounding.