Twoje pytanie to nie cała mapa wyszukiwania. Zbadałem 2058 odpowiedzi Gemini
Kiedy pytasz Gemini o coś konkretnego, model nie musi wpisać w wyszukiwarkę dokładnie tego, o co zapytałeś. Częściej przepisuje Twoje pytanie po swojemu - zmienia szyk, dokłada warunki, rozbija jedno zagadnienie na kilka mniejszych. To ma bezpośrednie znaczenie dla SEO i GEO: jeśli optymalizujesz treść tylko pod dosłowne brzmienie pytania, łatwo minąć się z tym, czego model naprawdę szuka.
Przeanalizowałem 2058 odpowiedzi Gemini razem z zapisanymi zapytaniami wyszukiwania i źródłami. Dwie liczby na początek:
- W 85,5% odpowiedzi poprzedzonych wyszukiwaniem (1258 z 1472 obserwacji z zapytaniami) żadne zapytanie nie było identyczne z pytaniem - nawet po sprowadzeniu obu tekstów do wspólnej postaci.
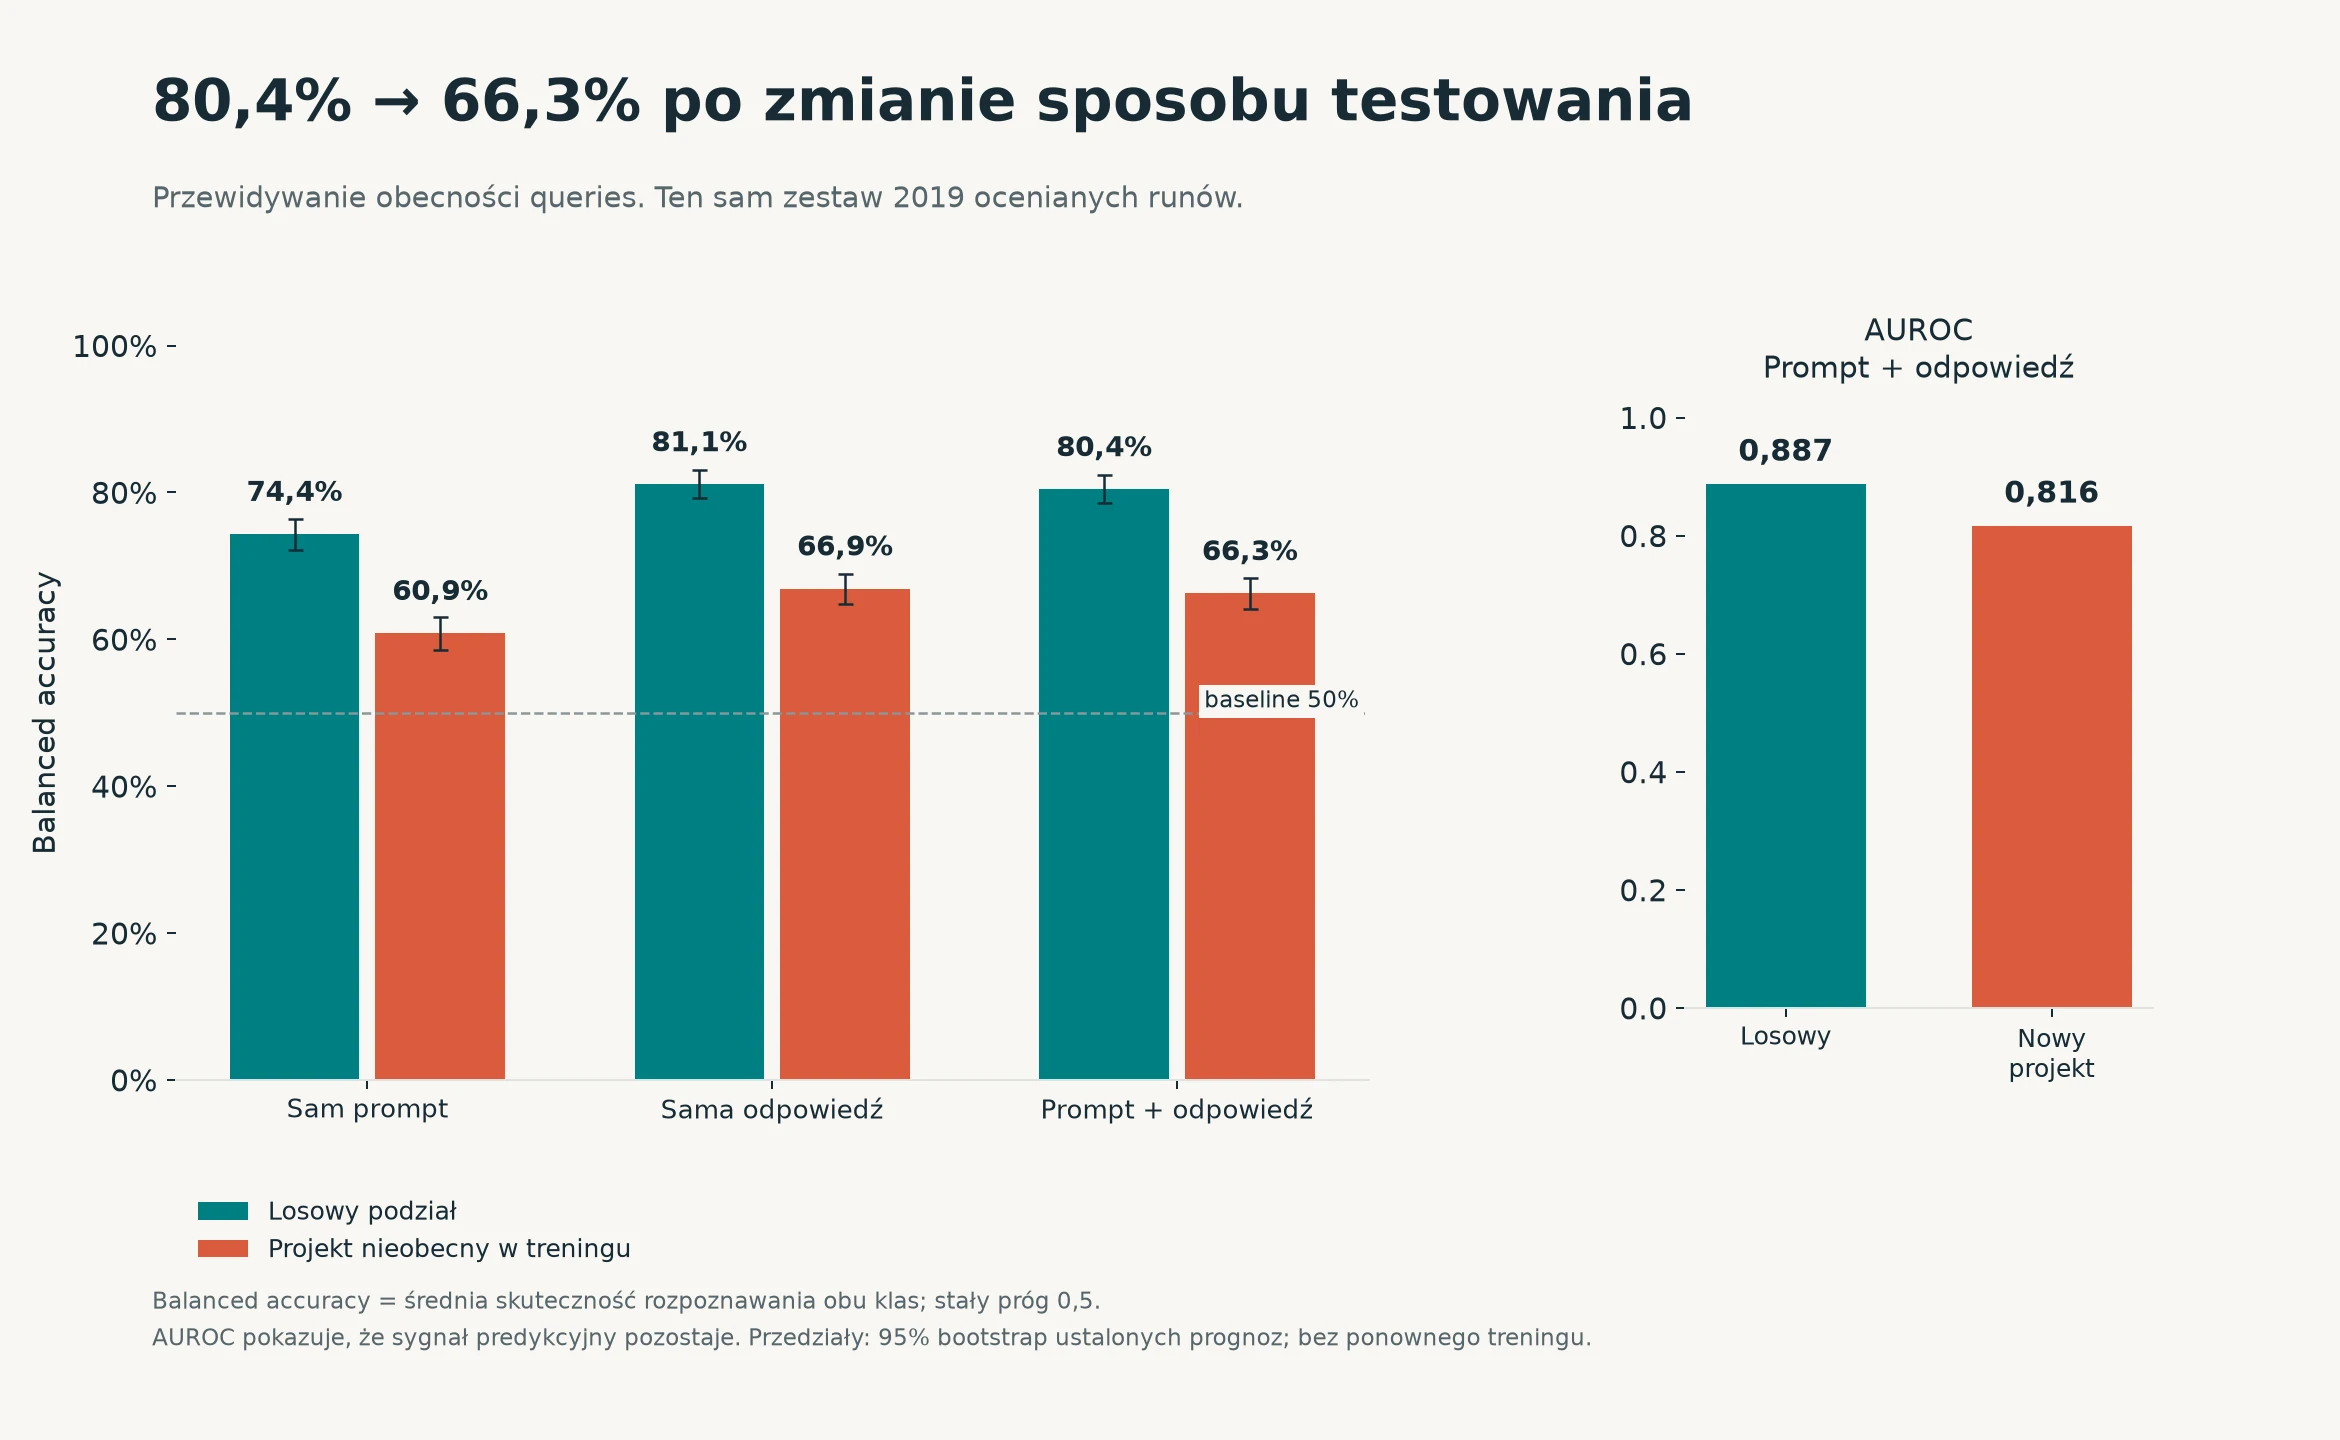
- Prosty model, który miał tylko zgadnąć „czy w ogóle było wyszukiwanie" na podstawie tekstu pytania i odpowiedzi, trafiał w 80,4% przy losowym podziale danych - ale spadał do 66,3%, gdy testowałem go na projekcie, którego wcześniej nie widział.
Pierwsza liczba mówi o tym, jak model przekształca pytanie. Druga - jak bardzo ocena „z zewnątrz" zależy od sposobu testu. Razem prowadzą do jednego praktycznego pytania: ile naprawdę wiemy o drodze do odpowiedzi, jeśli mierzymy wyłącznie jej finalny tekst?
Sprawdziłem relacje między pytaniem, zapytaniami wyszukiwania, przypisaniami źródeł do fragmentów odpowiedzi i samą odpowiedzią - na 2058 obserwacjach, 4574 zapisanych zapytaniach i 21 185 pozycjach źródłowych. Potem sprawdziłem, ile z tego da się odgadnąć prostym modelem mającym do dyspozycji wyłącznie tekst.
Od razu zastrzeżenie: to analiza konkretnego korpusu, zebranego od 11 czerwca do 19 września 2026 r., w którym dominują ubezpieczenia, faktoring, SEO i prawo pracy. Nie jest to reprezentatywny pomiar całego Gemini ani porównanie różnych asystentów AI.
1. Pytanie i zapytanie wyszukiwania to dwie różne rzeczy
W 1472 obserwacjach pojawiło się co najmniej jedno zapisane zapytanie wyszukiwania. Sprawdziłem, czy którekolwiek z nich było identyczne z pytaniem użytkownika - i stopniowo „przymykałem oko" na różnice zapisu.
Przy porównaniu surowych tekstów identycznego zapytania nie było w 98,4% przypadków. Po pominięciu wielkości liter, interpunkcji i odstępów - w 93,7%. Gdy dodatkowo zrównałem znaki diakrytyczne z ich odpowiednikami (np. „ż" z „z"), zostało 85,5%, czyli 1258 z 1472 obserwacji.
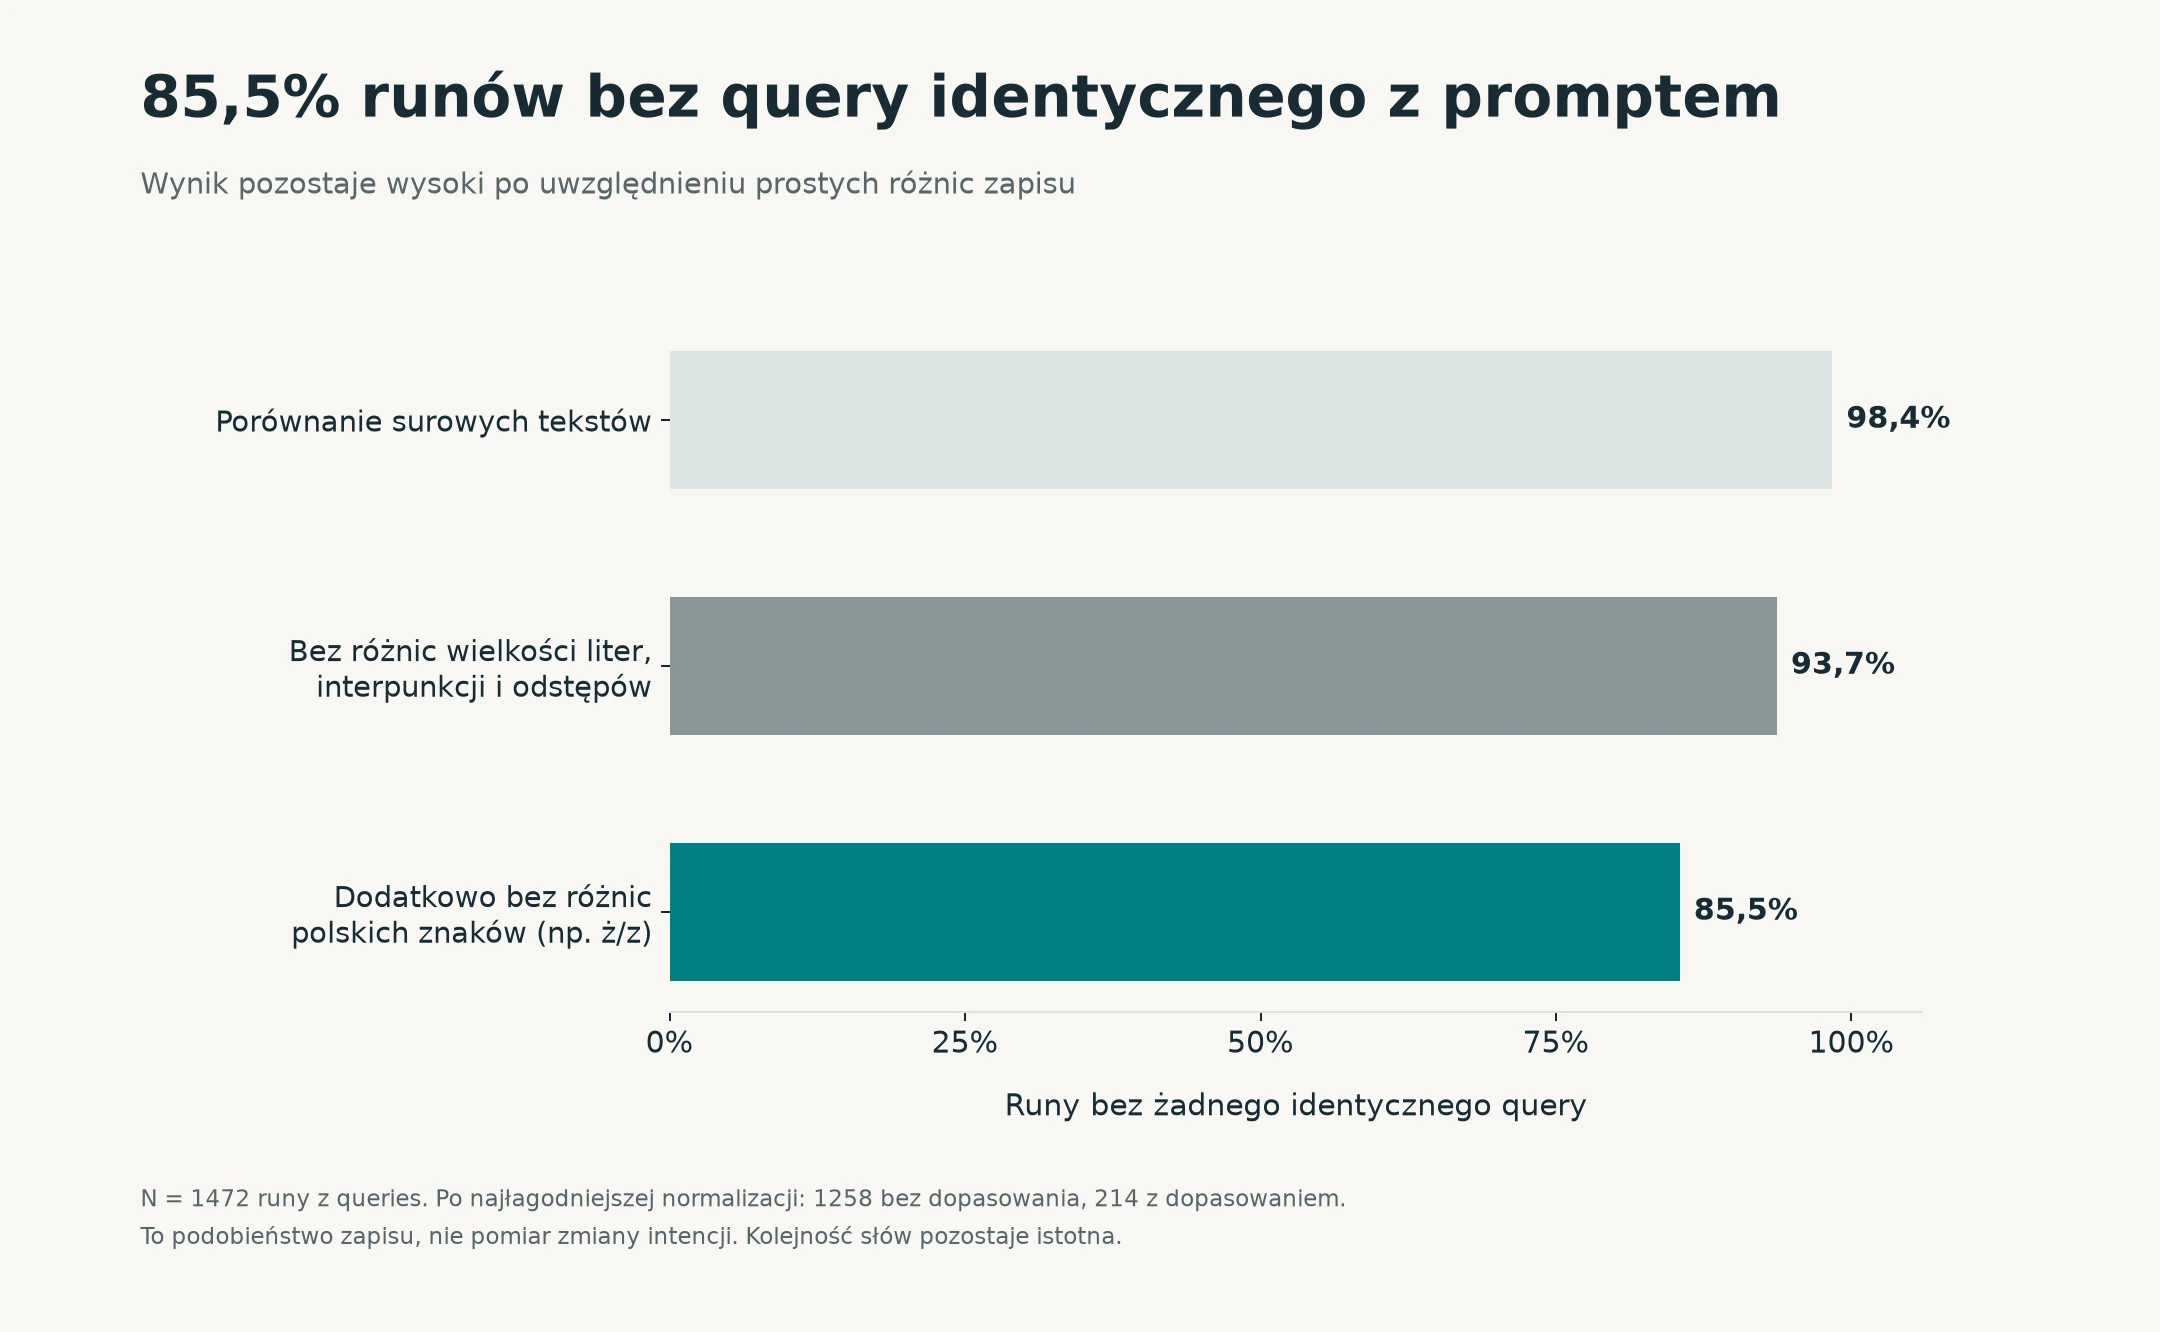
To mocny wynik dotyczący zgodności tekstu - ale uwaga na interpretację. Nie oznacza, że Gemini zmienił intencję użytkownika w 85,5% przypadków. Inny szyk słów, odmiana czy parafraza też wystarczą, żeby teksty przestały być identyczne, a moje porównanie zachowuje kolejność słów i nie sprowadza ich do form podstawowych.
Dlatego przejrzałem dodatkowo 60 losowych obserwacji z wyszukiwaniem. Widać w nich i zwykłe parafrazy, i coś ciekawszego: dokładanie warunków oraz rozbijanie szerszego zagadnienia na podproblemy. Pytanie o faktoring dla nowej firmy prowadziło do wyszukiwań o braku historii działalności i o finansowaniu od pierwszego dnia. Pytanie o nadgodziny dla szczególnych grup zawodowych rozdzielało się na wyszukiwania o poszczególnych zawodach. To nie dowód, że każda zmiana tekstu jest taką dekompozycją - to ilustracja, jak różne bywają te transformacje.
Co to znaczy dla Ciebie: osobno patrz na pytanie użytkownika, a osobno na konkretne zagadnienia, które trzeba rozstrzygnąć, żeby na nie odpowiedzieć. Sama zgodność treści z dosłownym pytaniem nie opisuje wszystkich zapytań pośrednich, które model może odpalić po drodze. Czy dopisanie tych zagadnień do strony realnie zwiększa jej widoczność - tego nie testowałem; to osobna hipoteza do eksperymentu.
2. Liczba źródeł nie mówi, jak rozłożone są przypisania
W obserwacjach z wyszukiwaniem mediana liczby różnych adresów źródłowych wyniosła 13. Ale trzy adresy z największą liczbą powiązań skupiały medianowo 48,6% wszystkich unikalnych par fragment odpowiedzi–adres. Innymi słowy: źródeł bywa sporo, lecz odpowiedź „opiera się" głównie o kilka z nich.
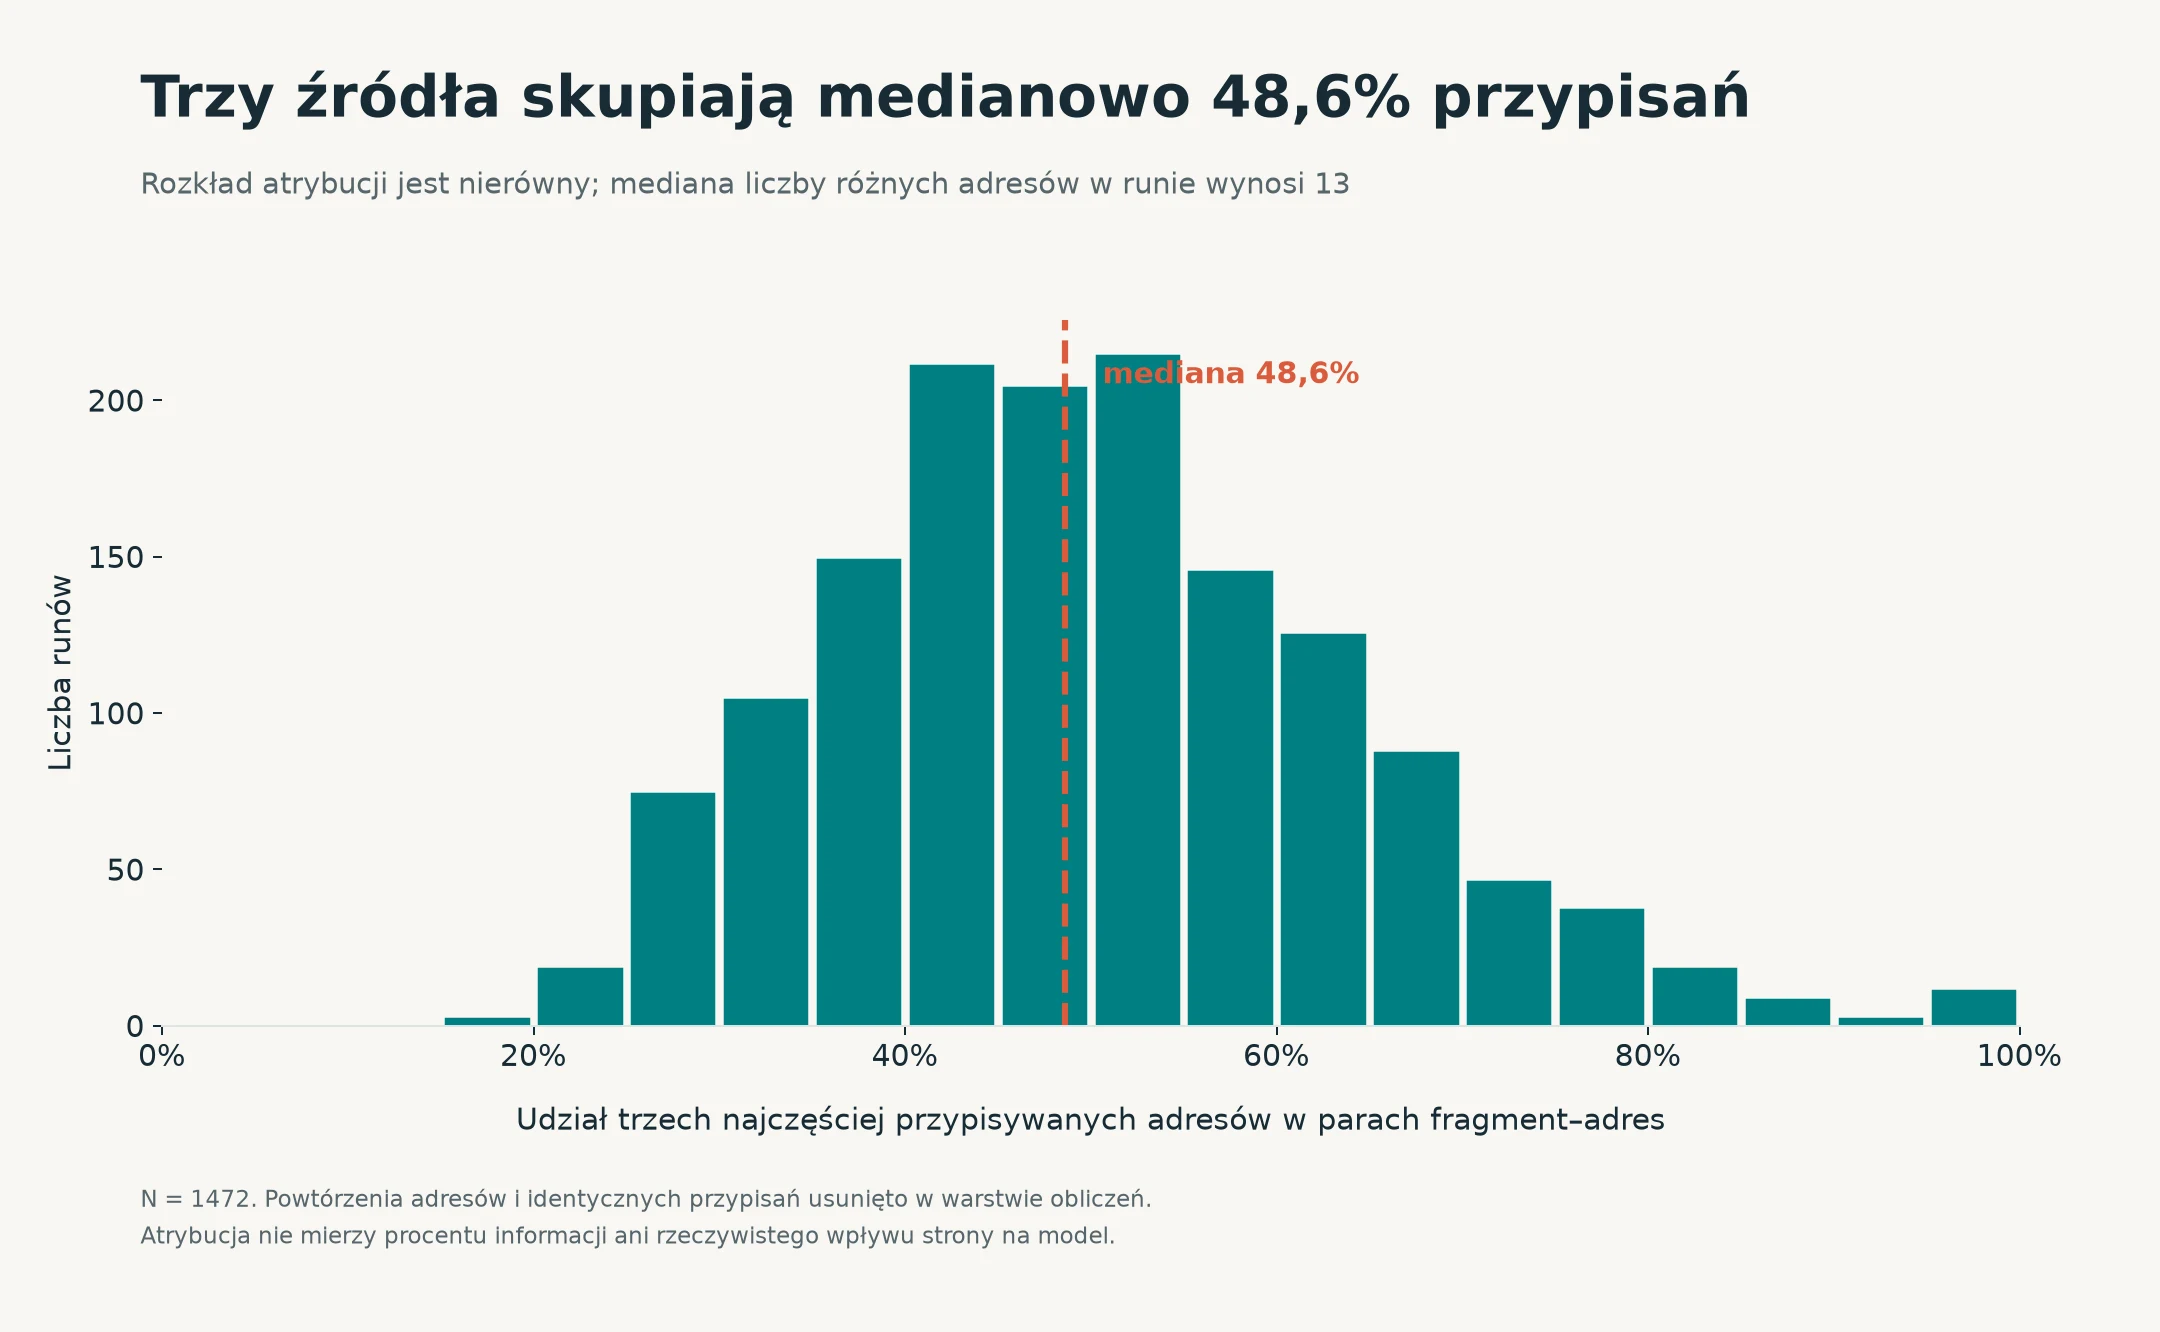
Liczyłem to ostrożnie - każda obserwacja ma tę samą wagę (nie sumowałem wszystkiego w jedną pulę, bo faworyzowałaby długie odpowiedzi). Dla kontroli policzyłem też inaczej: jeden fragment dostaje jeden punkt dzielony równo między przypisane mu adresy. Wtedy udział trójki czołowych adresów wyniósł 51,7% - wniosek o koncentracji ten sam, dokładna wartość zależy od definicji.
Kluczowe zastrzeżenie: 48,6% przypisań to nie 48,6% wiedzy, treści ani wpływu na model. Powiązanie fragmentu ze źródłem nie mierzy, ile informacji stamtąd pochodzi, ani nie dowodzi, że przypisanie jest trafne. Do tego dostępna lista pozycji źródłowych nie musi być kompletna.
Co to znaczy dla Ciebie: obecność źródła i liczba powiązanych z nim fragmentów to dwie różne miary - raportuj obie i zawsze opisuj, jak je liczysz. Z takiego wyniku nie da się zbudować rankingu „wpływu domen na Gemini".
3. Ocena „z zewnątrz" gorzej działa na nowym temacie
Czy z samego pytania i gotowej odpowiedzi da się przewidzieć, że w ogóle było wyszukiwanie? Zbudowałem prostego „obserwatora" - model na statystycznych cechach tekstu (regresja logistyczna). Dostawał samo pytanie, samą odpowiedź albo oba teksty. Nie widział zapytań, źródeł, tematu, projektu ani daty. To celowo prymitywny test, nie próba sił zaawansowanego LLM-a.
Najpierw sprawdziłem go przy losowym podziale danych, a potem trudniej: odkładałem cały jeden duży projekt i uczyłem model na pozostałych. Oba sposoby porównałem na dokładnie tych samych 2019 obserwacjach:
| Co widział obserwator | Losowy podział | Nowy projekt (nieobecny w treningu) |
|---|---|---|
| Samo pytanie | 74,4% | 60,9% |
| Sama odpowiedź | 81,1% | 66,9% |
| Pytanie i odpowiedź | 80,4% | 66,3% |
W tabeli jest balanced accuracy - uśredniona skuteczność rozpoznawania obu przypadków (było wyszukiwanie / nie było), gdzie zgadywanie na oślep daje 50%. Dla wariantu „pytanie i odpowiedź" różnica między testami to 14,2 punktu procentowego - i nie wynika z mniejszej próbki treningowej (sprawdziłem to osobno, wynik się utrzymał).
Co ważne, spadek nie oznacza, że odpowiedź niczego nie zdradza o wyszukiwaniu. Model po zmianie projektu wciąż całkiem nieźle układał obserwacje od najmniej do najbardziej prawdopodobnego wyszukiwania - problemem był raczej stały próg decyzji, który przestawał pasować do nowego tematu. Temat, czas i sposób zadawania pytań są ze sobą powiązane, więc nie zrzucam spadku na jedną przyczynę.
Co to znaczy dla Ciebie: wynik uzyskany po losowym wymieszaniu danych nie wystarcza, żeby ocenić, jak narzędzie zadziała na nowej branży czy nowym kliencie. Potrzebny jest osobny test „na nieznanym temacie". I nawet dobry detektor „czy było wyszukiwanie" nadal nie odtwarza konkretnych zapytań ani drogi do odpowiedzi.
4. Odtworzenie liczby zapytań jest jeszcze trudniejsze
Drugi obserwator miał przewidzieć nie „czy", ale ile było zapytań - i tylko w obserwacjach, w których wyszukiwanie faktycznie wystąpiło (żeby nie punktował za rozpoznawanie zer). Na wspólnej próbie 1446 obserwacji mylił się średnio o 1,20 zapytania przy losowym podziale. Prosta prognoza „zawsze podaj medianę z danych treningowych" myliła się o 1,30 - więc model był odrobinę lepszy.
Ale na nowych projektach błąd modelu urósł do 1,39, a prosta mediana dalej trzymała 1,30. Tu, według tej miary, zwykły punkt odniesienia okazał się lepszy od modelu.
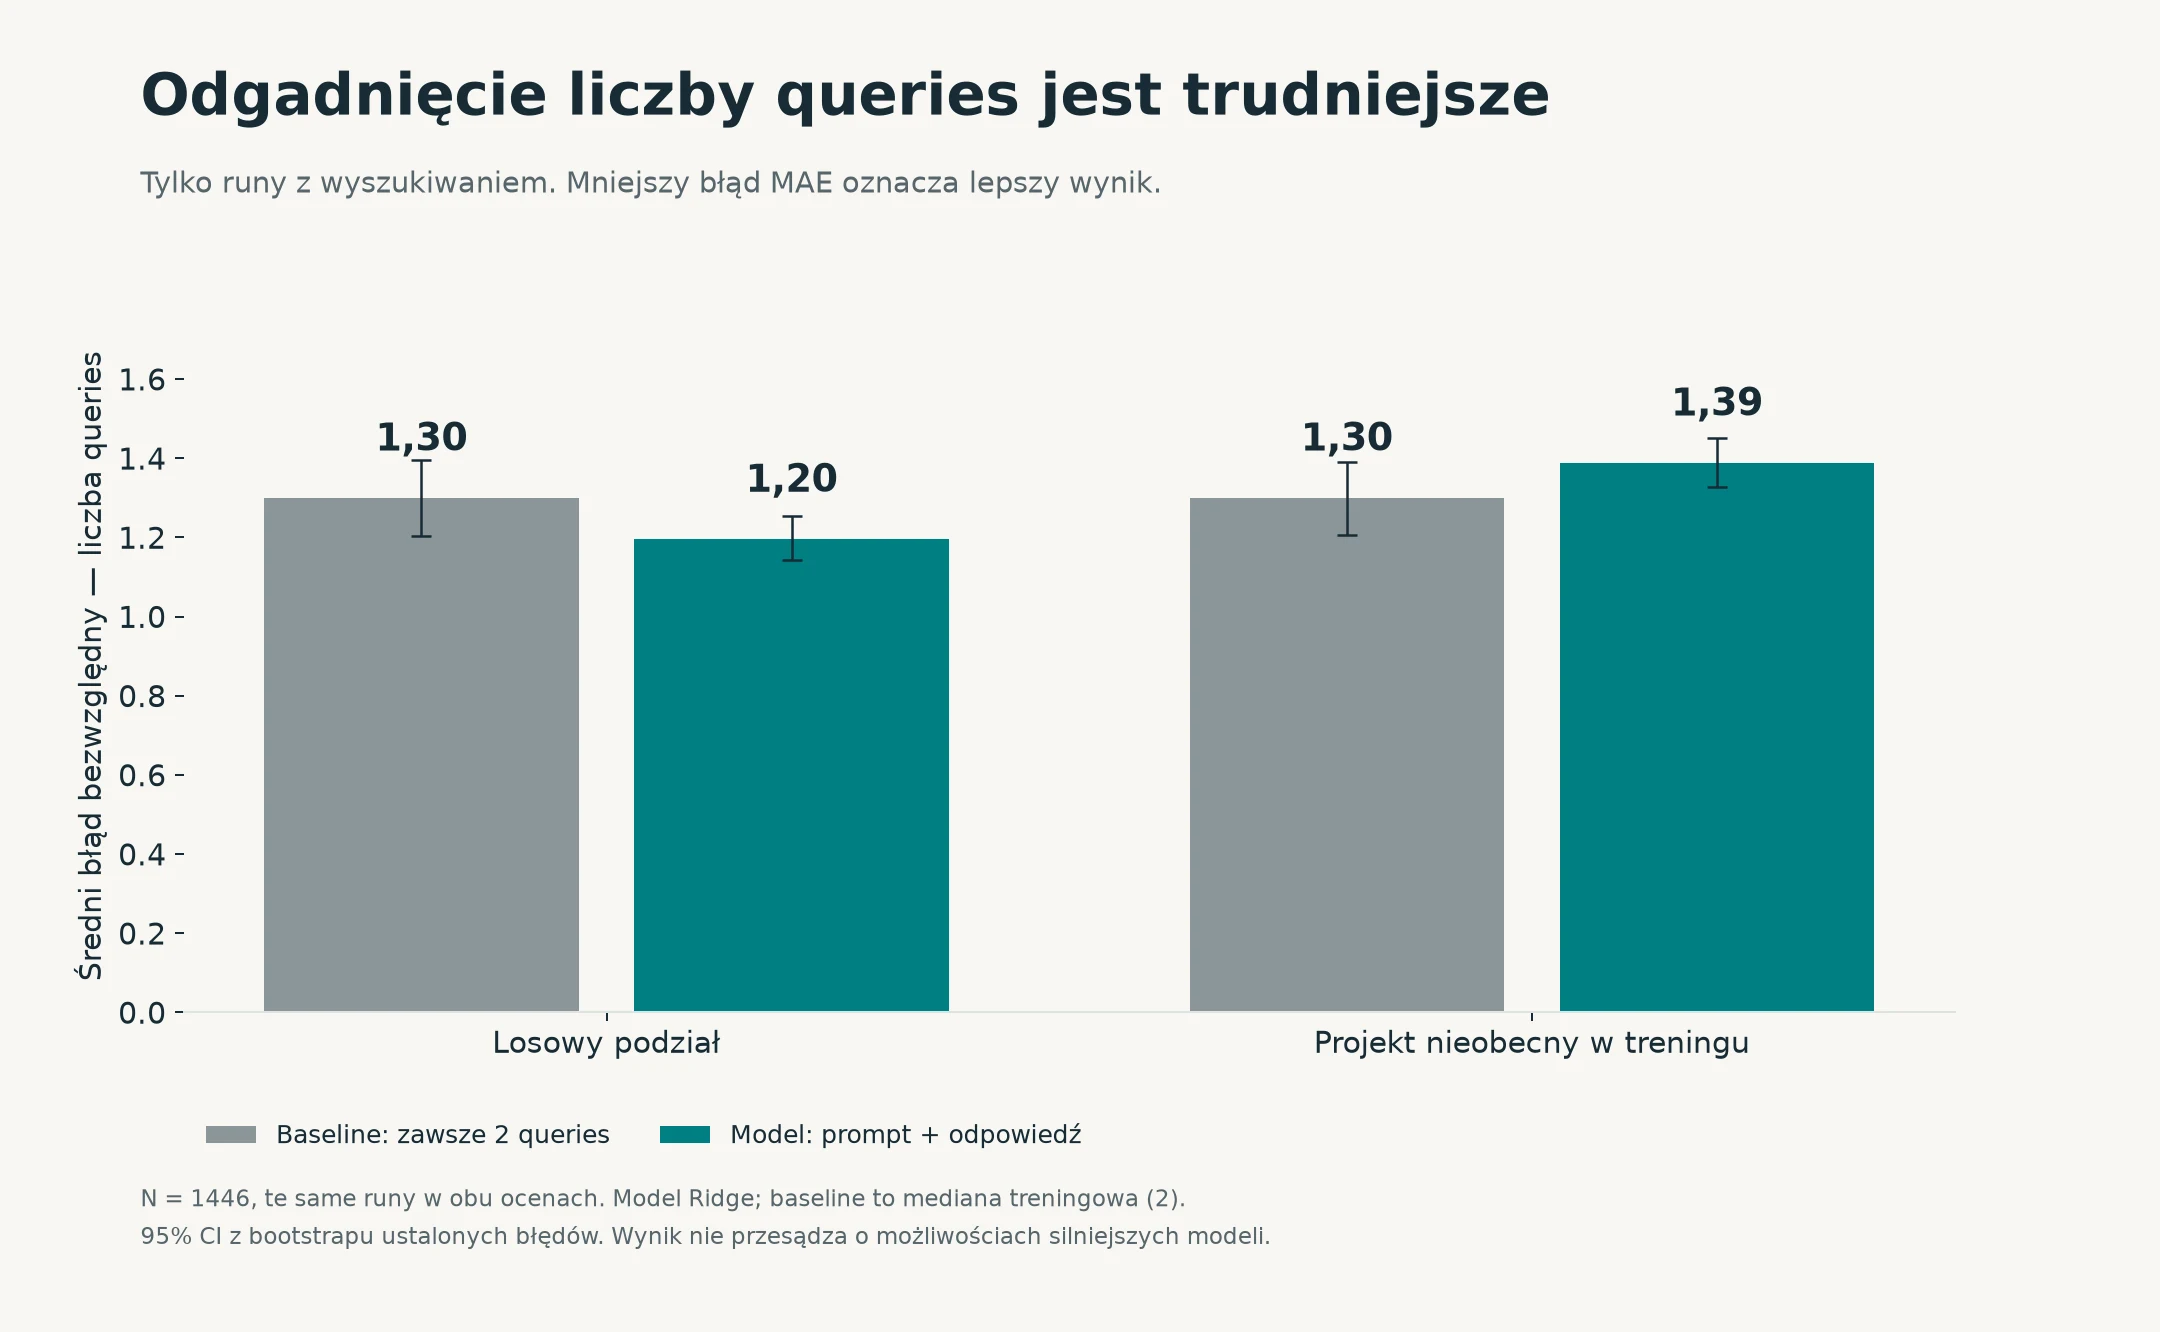
To nie znaczy, że w odpowiedziach nie ma żadnej informacji o liczbie zapytań - jest, ale niewielka. Praktyczny wniosek jest prosty: „czy wyszukiwanie prawdopodobnie było" i „ile go było" to dwa różne zadania o różnej trudności. Skuteczność każdego trzeba mierzyć osobno.
5. Wynik 89,4% potrafi wyglądać lepiej, niż działa
W teście czasowym odłożyłem ostatni dzień obserwacji - 540 odpowiedzi, z czego 460 miało zapisane zapytania. Obserwator na pytaniu i odpowiedzi osiągnął 89,4% accuracy. Brzmi świetnie. Tyle że strategia „zawsze zgaduj, że było wyszukiwanie" dawała już 85,2%, bo ta klasa dominowała w próbie. Po uczciwym przeliczeniu (balanced accuracy) model miał 70,1%, a taka naiwna strategia - 50%.
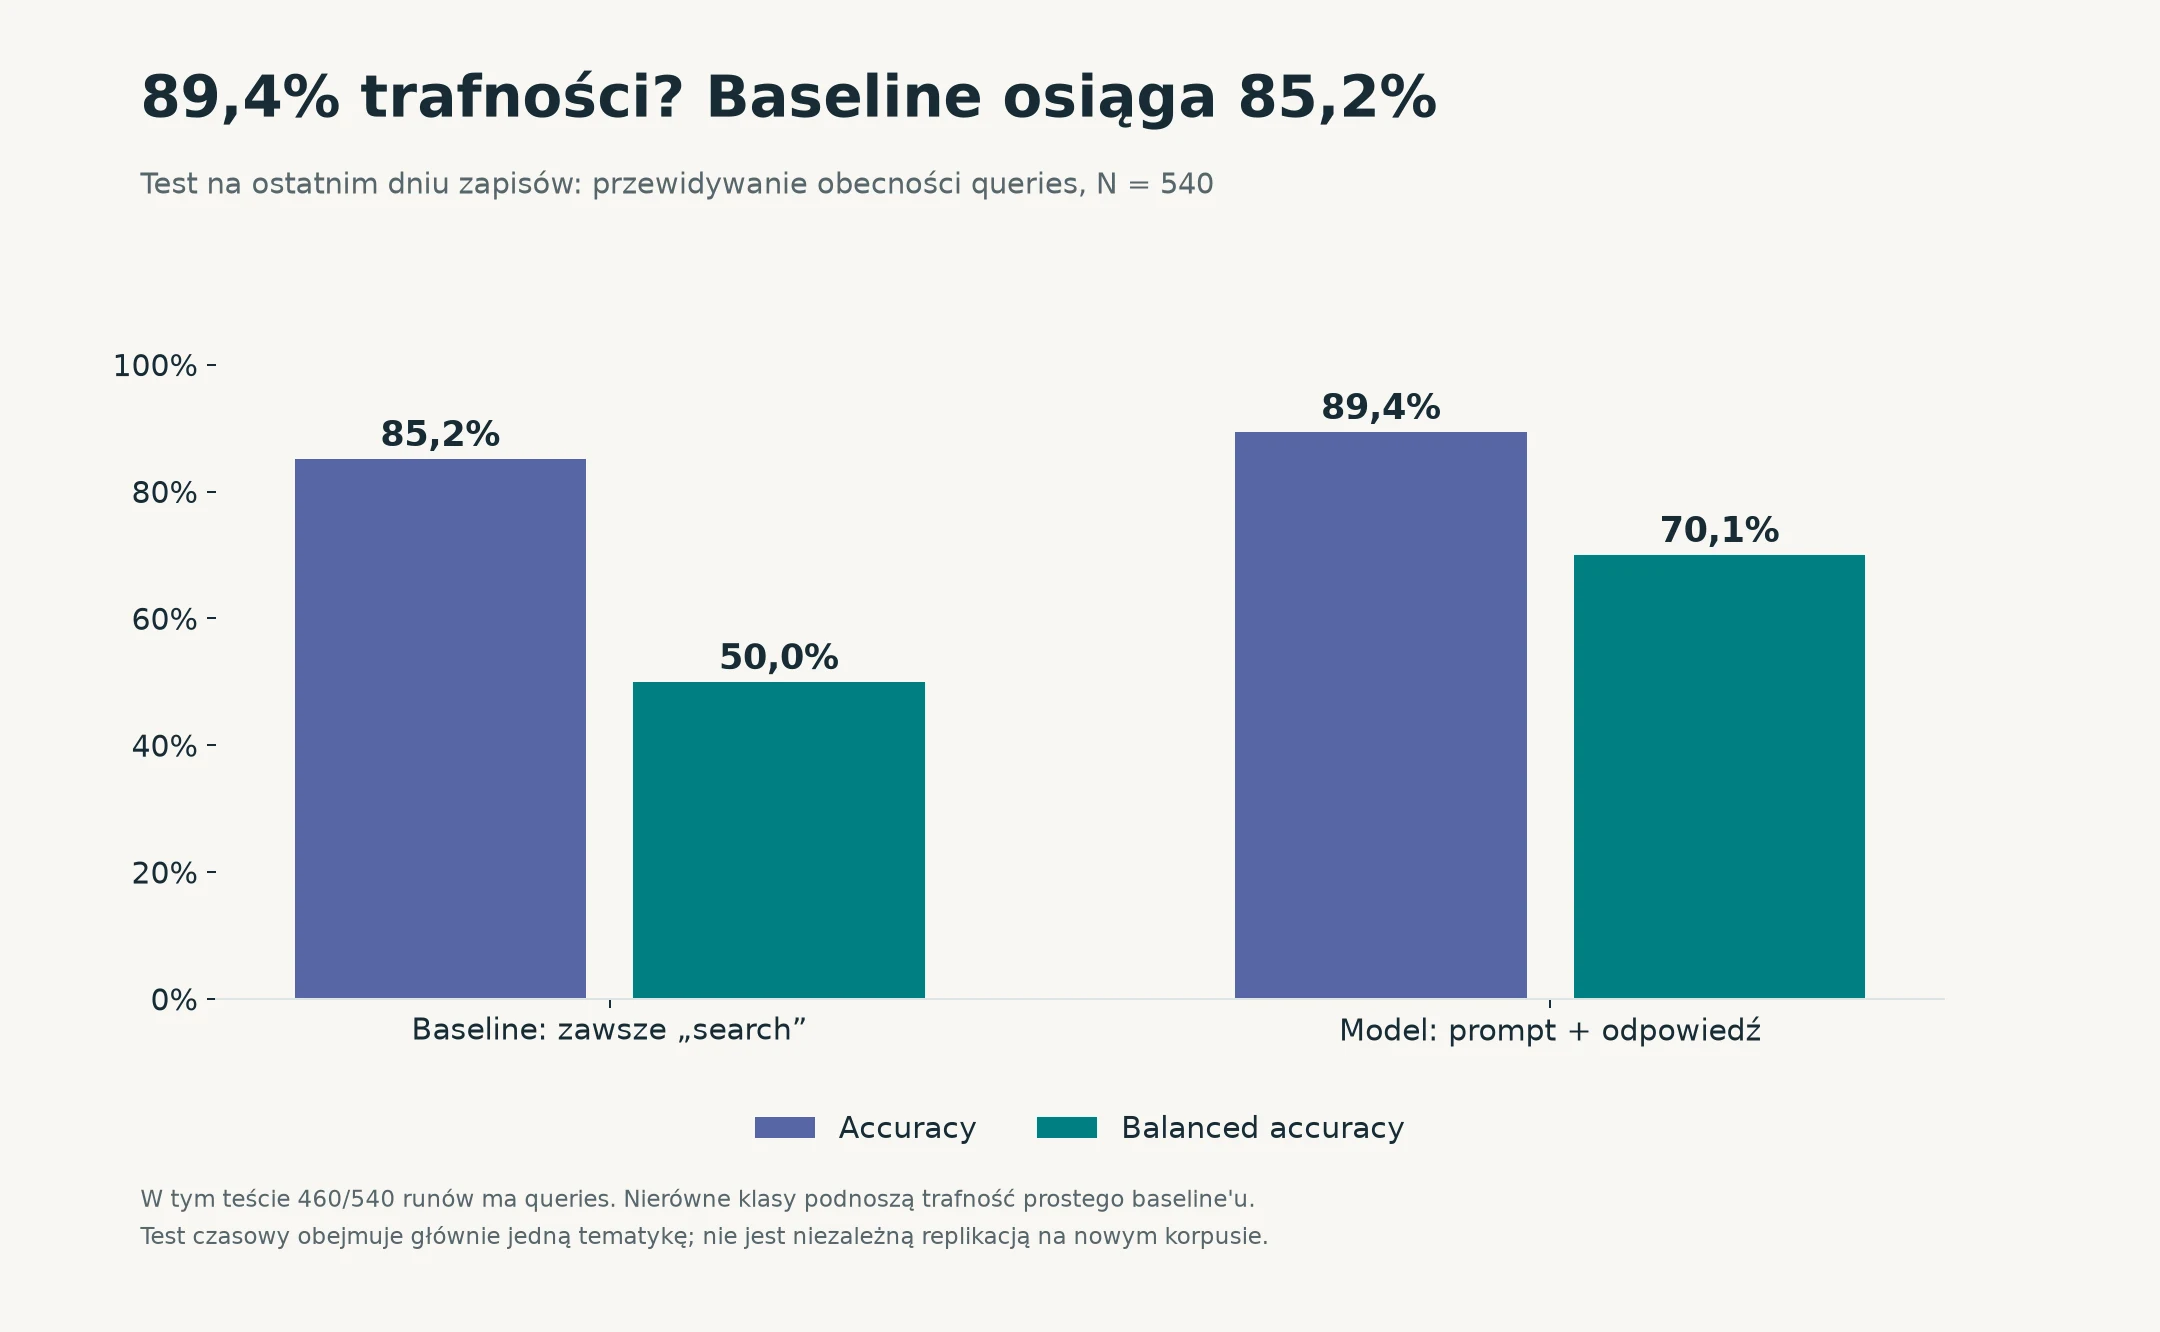
Model wniósł realną informację - ale samo „89,4%" jej nie pokazuje. Bez podania, ile było której klasy i jak wypada prosty punkt odniesienia, łatwo przecenić taki wynik. To jedna z najczęstszych pułapek w raportach o „skuteczności AI". Ten test dotyczy zresztą jednego dnia zdominowanego przez jeden projekt, więc nie mierzy ogólnej odporności w czasie.
6. Długa odpowiedź to nie licznik wyszukiwań
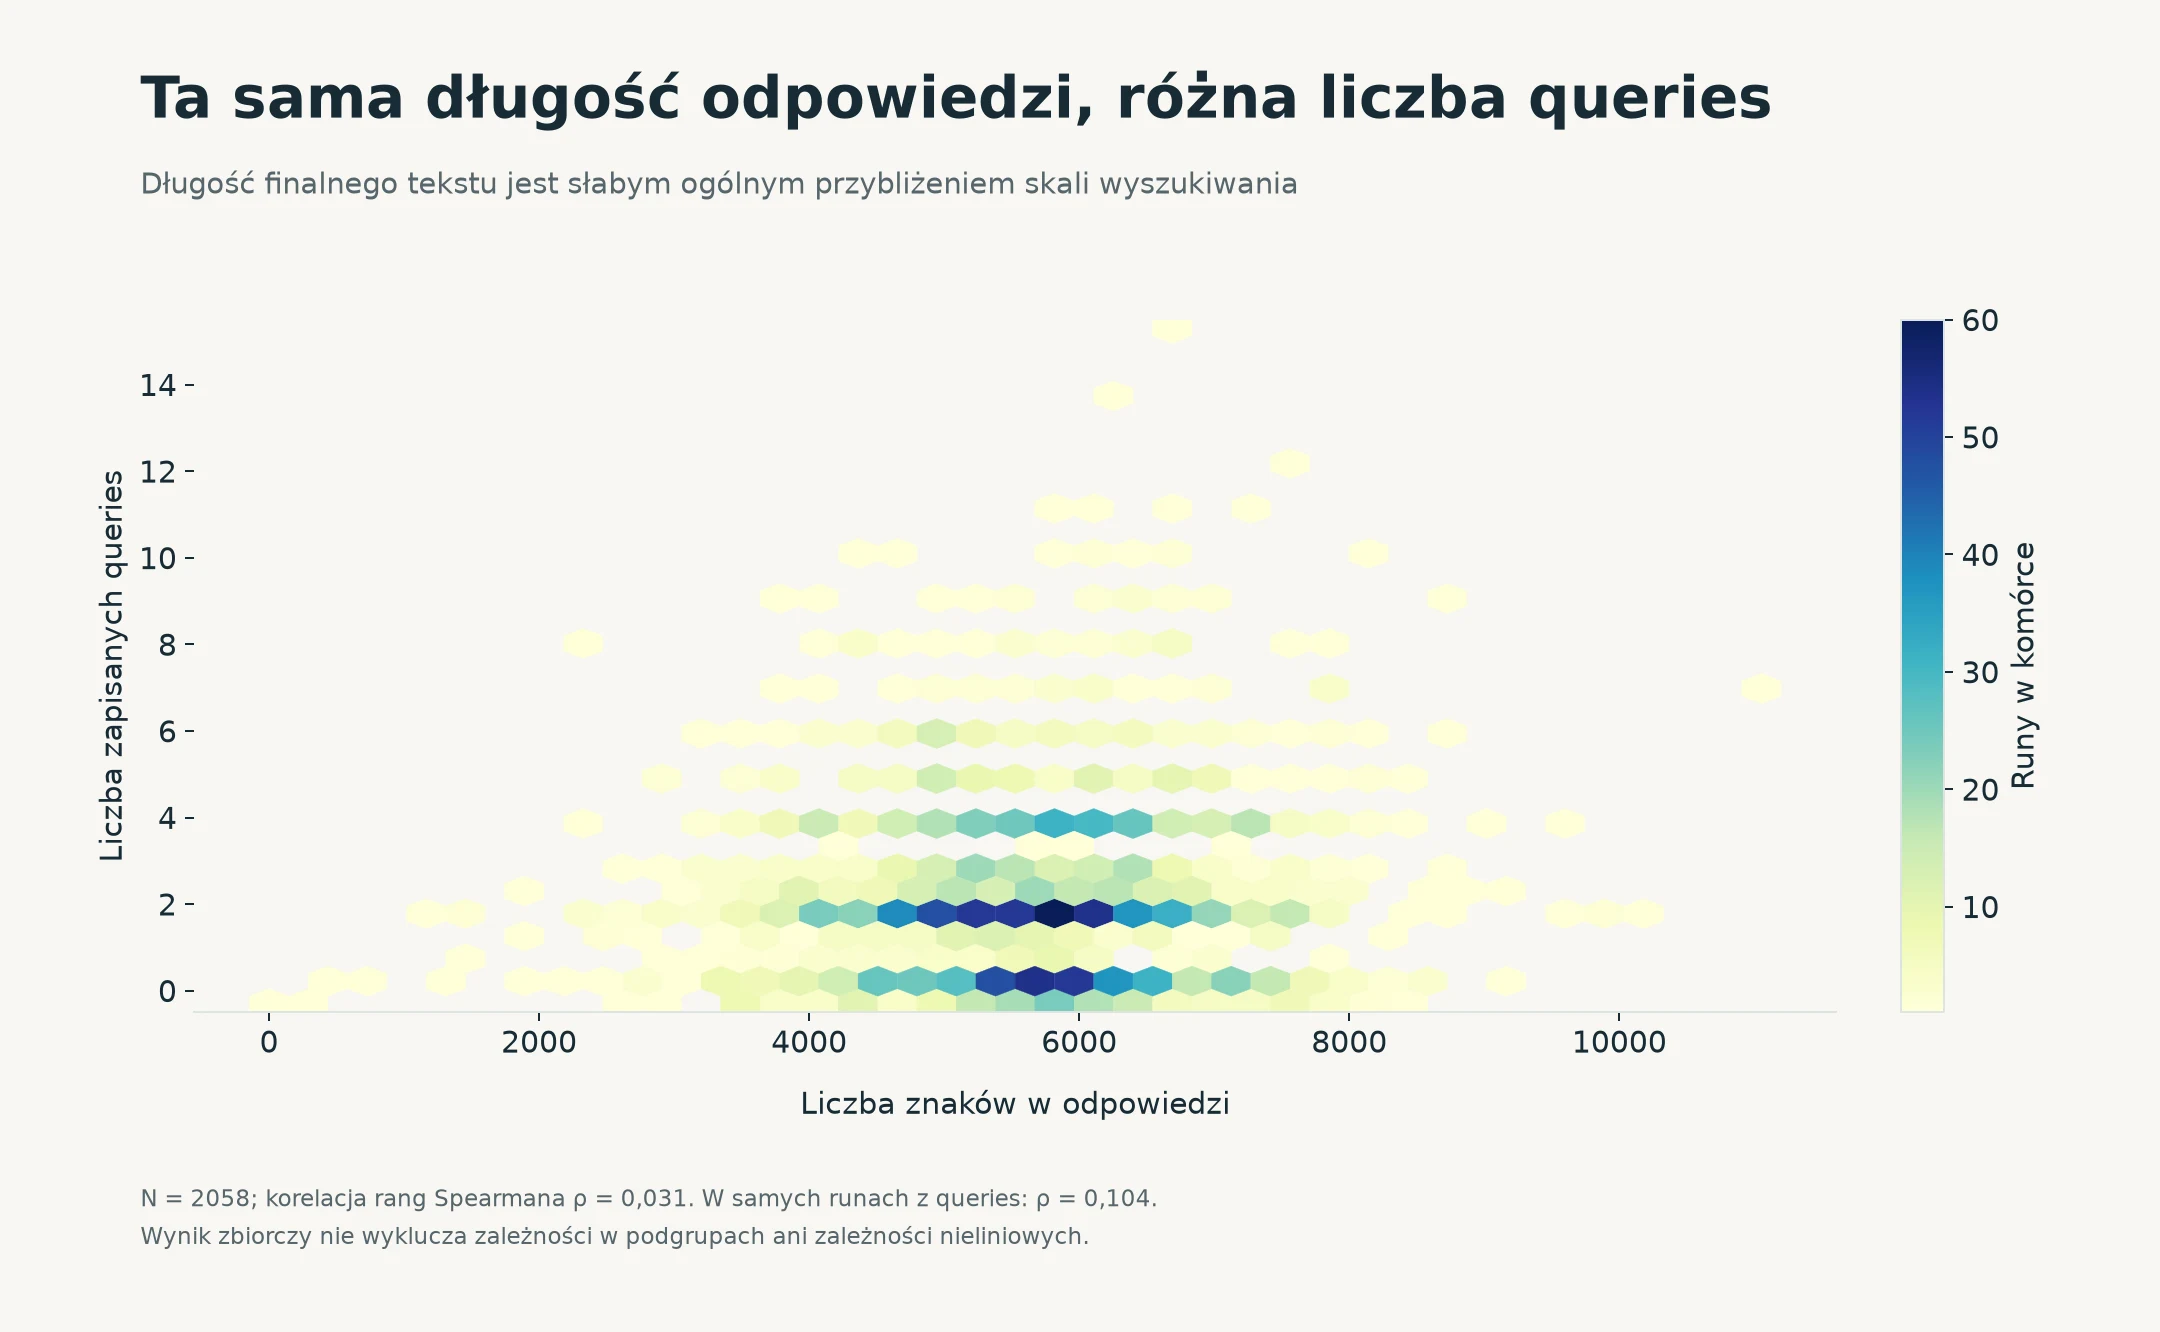
Kusi, żeby zakładać: dłuższa odpowiedź = więcej wyszukiwań. W całym korpusie związek długości odpowiedzi z liczbą zapytań był praktycznie zerowy (korelacja rang 0,031; wśród obserwacji z wyszukiwaniem 0,104). W jednej większej grupie sięgał 0,342 - czyli bywa, ale nie jest to uniwersalny przelicznik. Długość i formatowanie mogą być użyteczną wskazówką, ale wymagają sprawdzenia w konkretnym zastosowaniu.
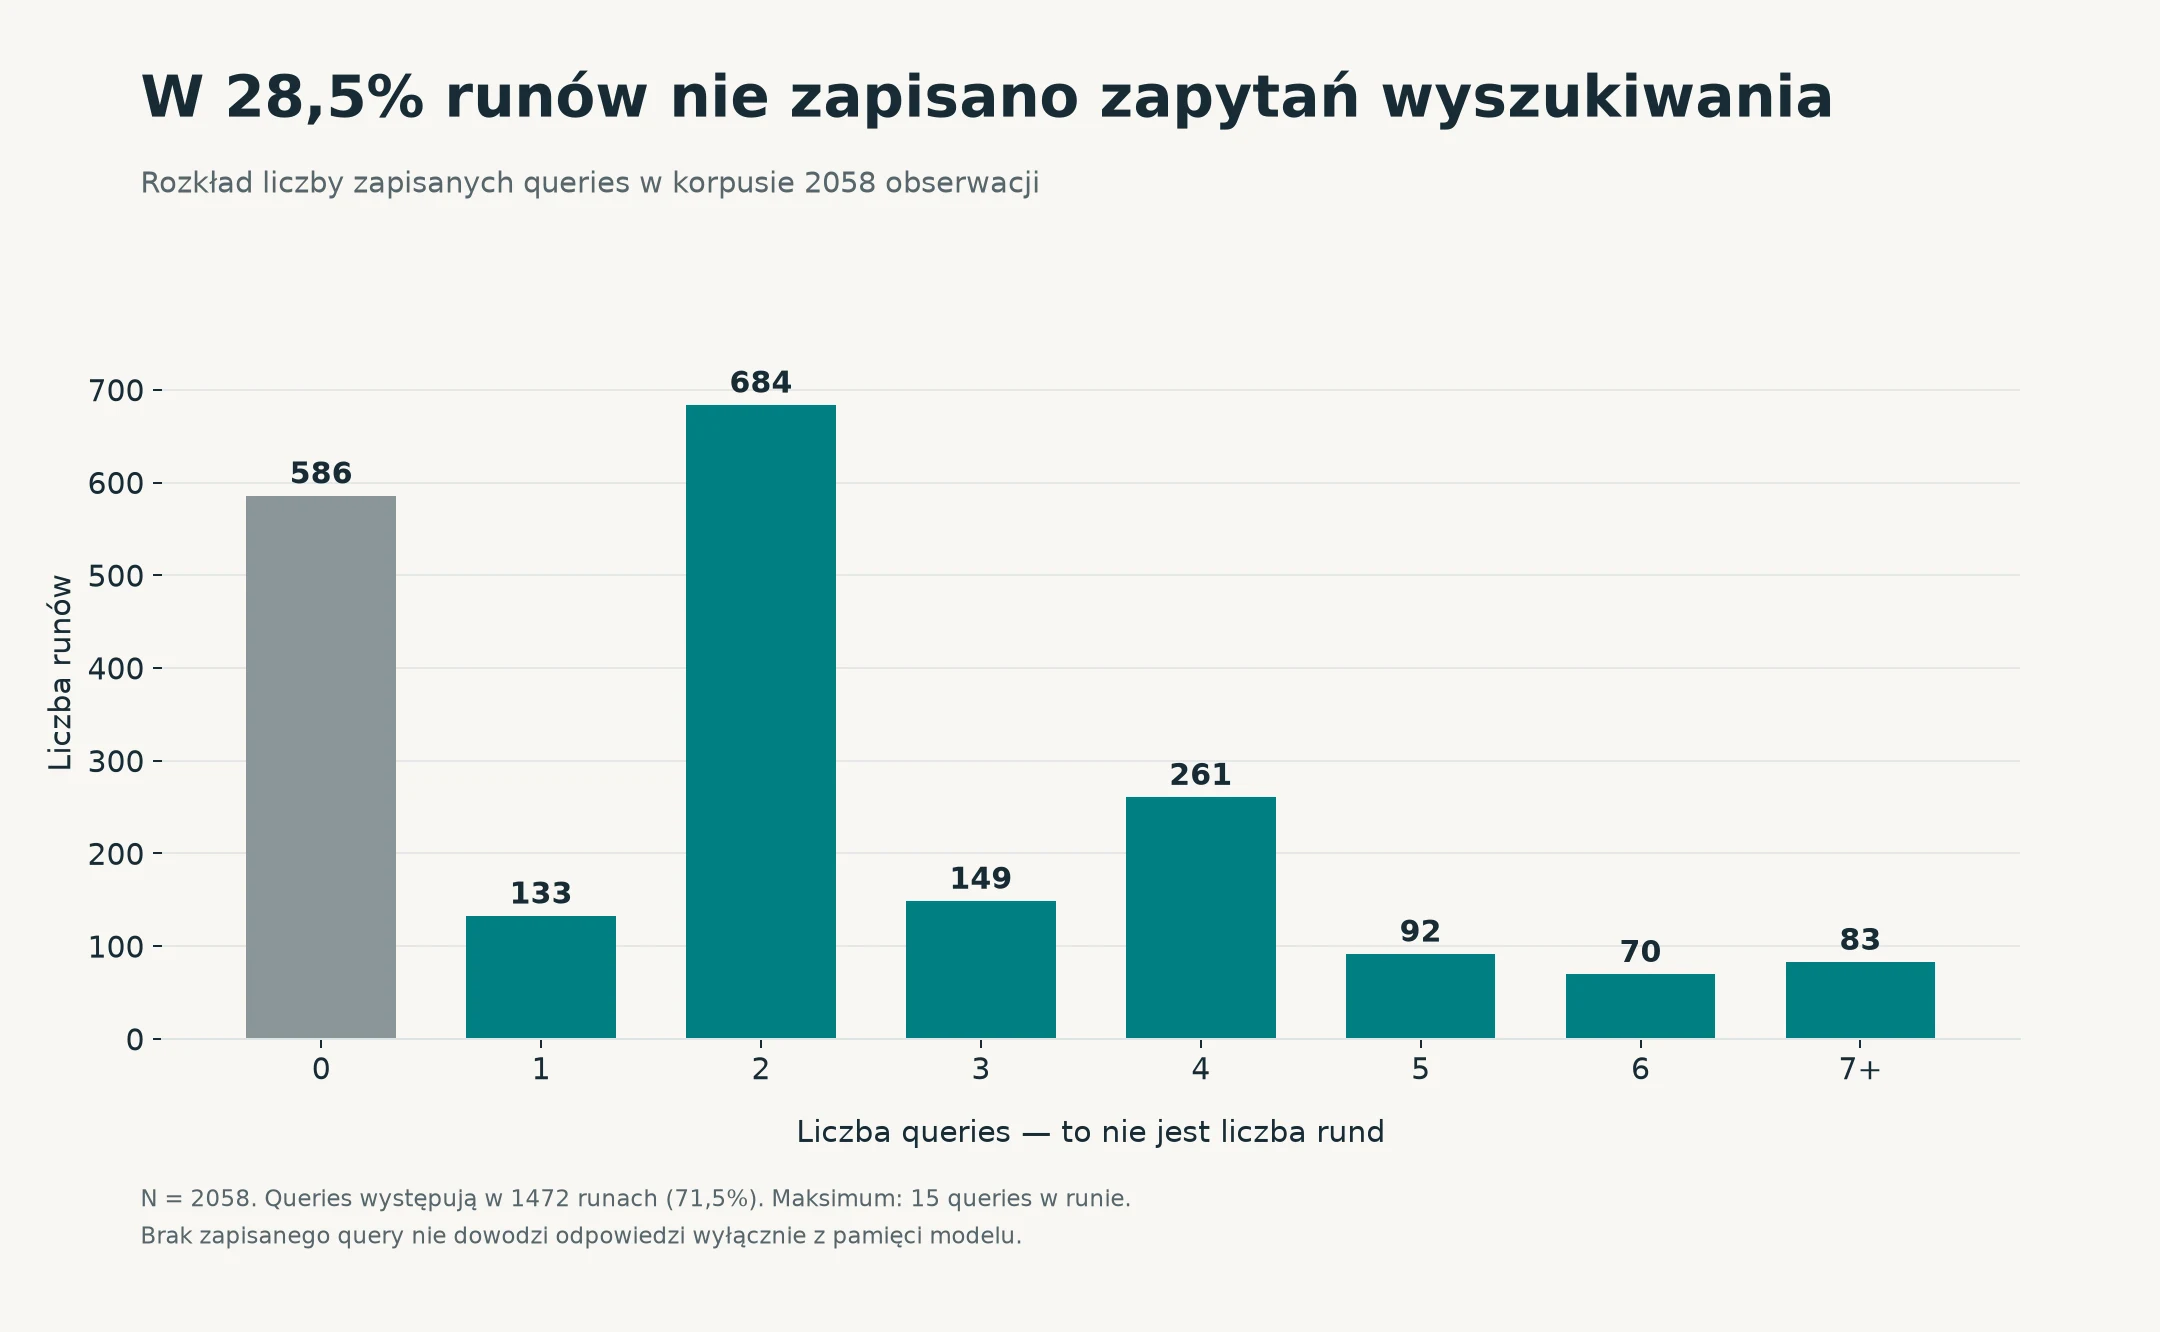
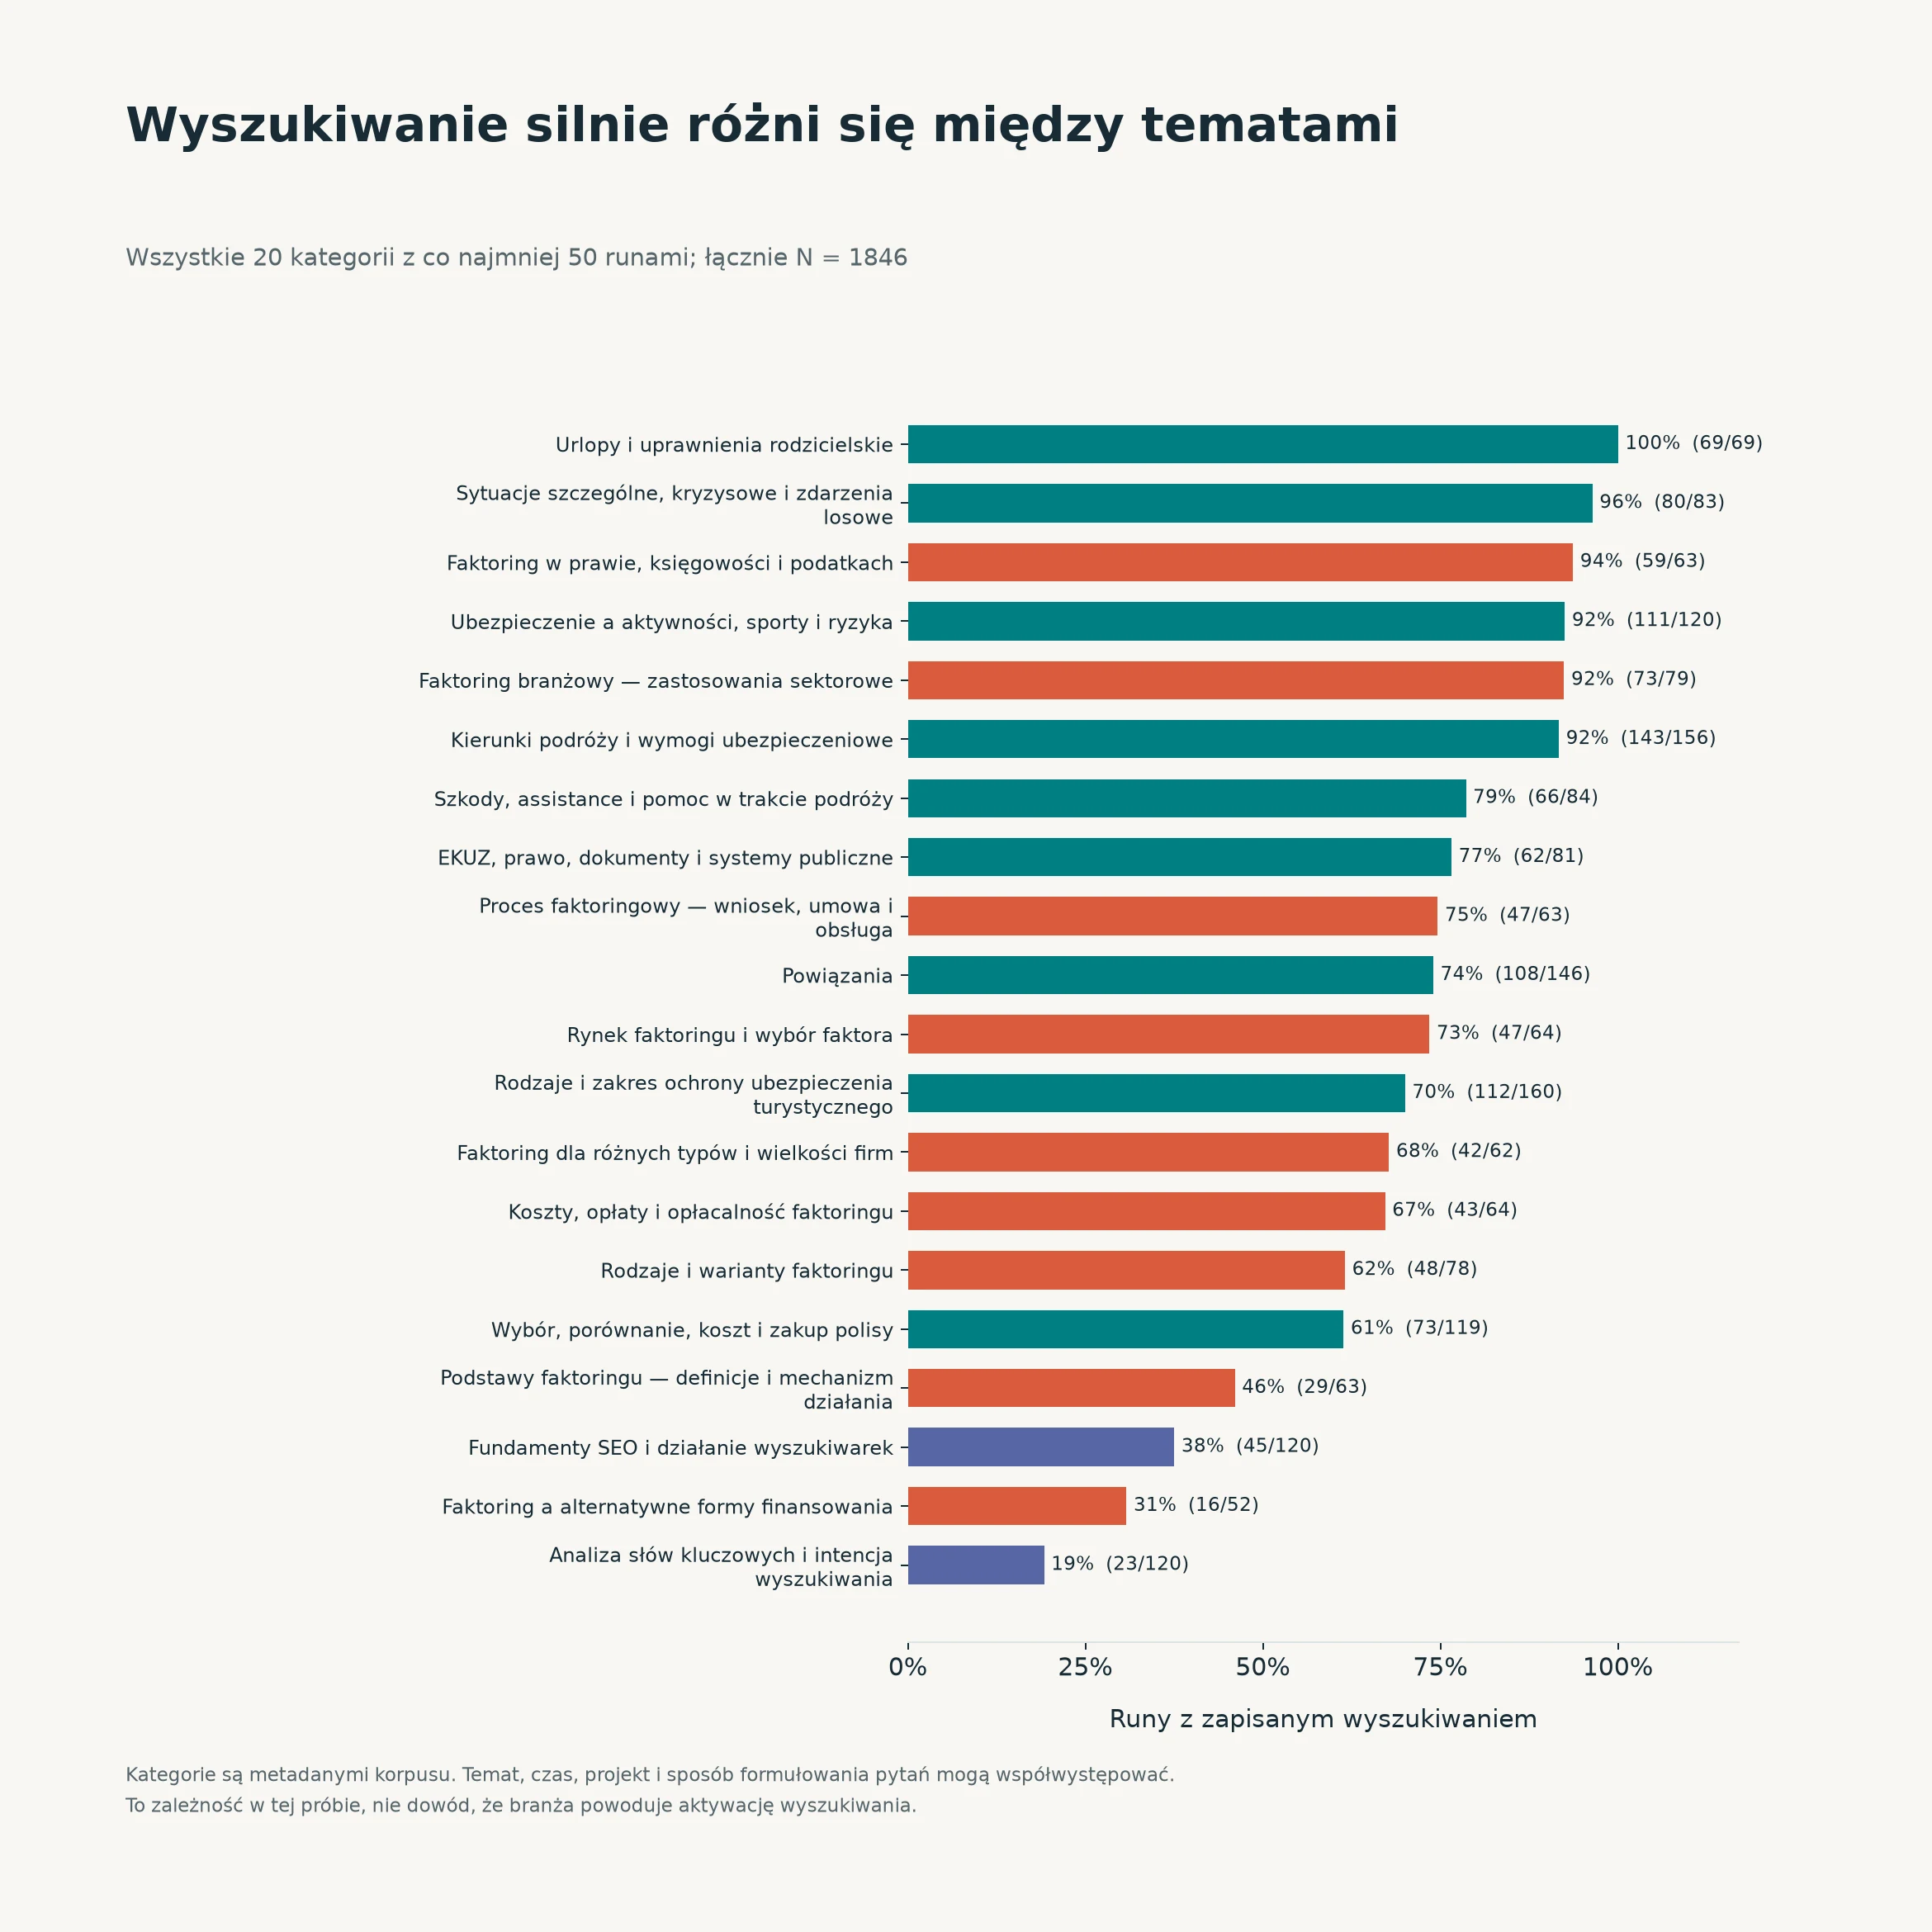
Podobnie z samą częstością wyszukiwania. W 586 z 2058 obserwacji (28,5%) nie zapisano żadnego zapytania - ale brak zapisanego zapytania nie dowodzi, że odpowiedź powstała wyłącznie z pamięci modelu. Różnice między tematami są przy tym ogromne: w kategorii „analiza słów kluczowych" wyszukiwanie było w 23 obserwacjach na 120, a w kategorii „urlopy" - w 69 na 69.
Co z tego wynika dla SEO i GEO
Z tej analizy płyną trzy konkretne zmiany w sposobie mierzenia widoczności w AI:
- Oddzielaj pytanie od zapytań pośrednich. To osobne teksty, często o różnym poziomie szczegółowości. Zgodność z dosłownym pytaniem nie wyczerpuje tematu - patrz też na podproblemy, które model musi rozstrzygnąć.
- Oddzielaj obecność źródła od rozkładu jego przypisań. Lista źródeł i liczba fragmentów powiązanych z danym źródłem odpowiadają na inne pytania. Żadna z tych miar nie jest automatycznie miarą „wpływu".
- Testuj narzędzia na nowym temacie, nie tylko po losowym wymieszaniu. Podawaj miary odporne na dominującą klasę (jak balanced accuracy), liczebności i wyniki podgrup - inaczej ładny procent może niewiele znaczyć.
To wskazówki dotyczące pomiaru, a nie gotowy przepis na więcej cytowań. Nie robiłem interwencji na stronach ani eksperymentu z pozycjonowaniem treści - to kolejny krok, nie wniosek z tej analizy.
Najważniejsze jest jedno rozróżnienie: finalna odpowiedź zawiera sygnały o wyszukiwaniu, ale to, jak dobrze da się je odczytać, zależy od zadania i warunków testu. W tym korpusie względnie niezłe wykrywanie „czy było wyszukiwanie" nie przełożyło się na równie dobre przewidywanie „ile go było" na nowych tematach. Audyt odpowiedzi AI powinien jasno mówić, którą z tych rzeczy naprawdę mierzy.
Zakres i ograniczenia
To analiza obserwacyjna i eksploracyjna, na jednym korpusie - nie na losowej próbie całego ruchu użytkowników. Nie testowałem powtarzalności tych samych pytań, innych wersji Gemini, innych asystentów ani silnych modeli jako obserwatorów. Pozycji źródłowej nie traktuję jako dowodu przeczytania strony, przypisania - jako pomiaru wpływu, a liczby zapytań - jako liczby rund wyszukiwania. Nie rozstrzygam też, czy model preferuje źródła oficjalne; dostępne dane na to nie wystarczają. Nazwy miar i te ograniczenia są częścią wyniku, nie przypisem do pominięcia.